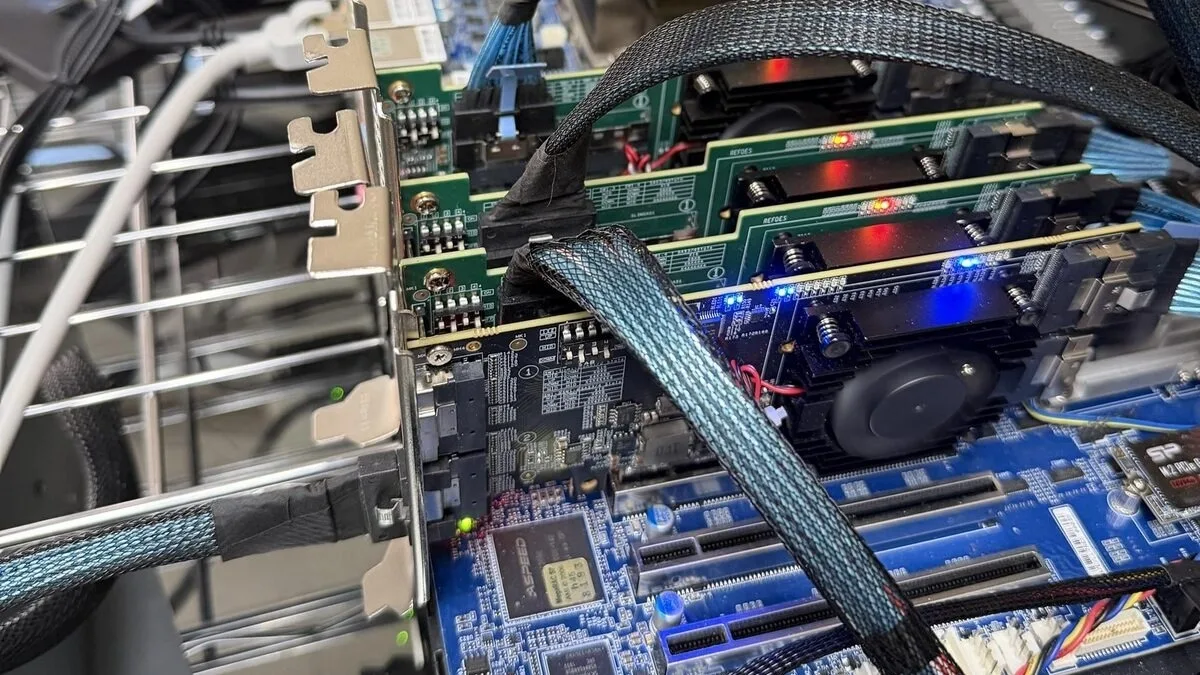
一位美国律师在技术社区晒出了自己的”私人 AI 服务器”:花费 9450 美元(按当时汇率约合 63239 元人民币)购入 12 张二手英伟达 Tesla V100 SXM2 32GB 显卡,通过 NVLink 与 PCIe 组成可协同推理的本地集群,用来运行 DeepSeek-V4.1-Flash 模型。在单代码流测试中,这套系统的生成速度达到每秒 157 至 184 个词元,快于已公开的 4 台 DGX Spark 组合,而硬件成本仅约为 3 台 DGX Spark 的一半。
把 15360 个专家”塞进”显卡
这套系统采用 3 个流水线阶段(PP3)、每阶段 4 卡张量并行(TP4)的结构,共 12 张 V100。运行的是 DeepSeek-V4.1-Flash 模型,并使用 4bit NVFP4 量化。发帖者称,每个专家被压缩至约 15360 个参数,使 12 张显卡能够分别承载模型中的专家分片。
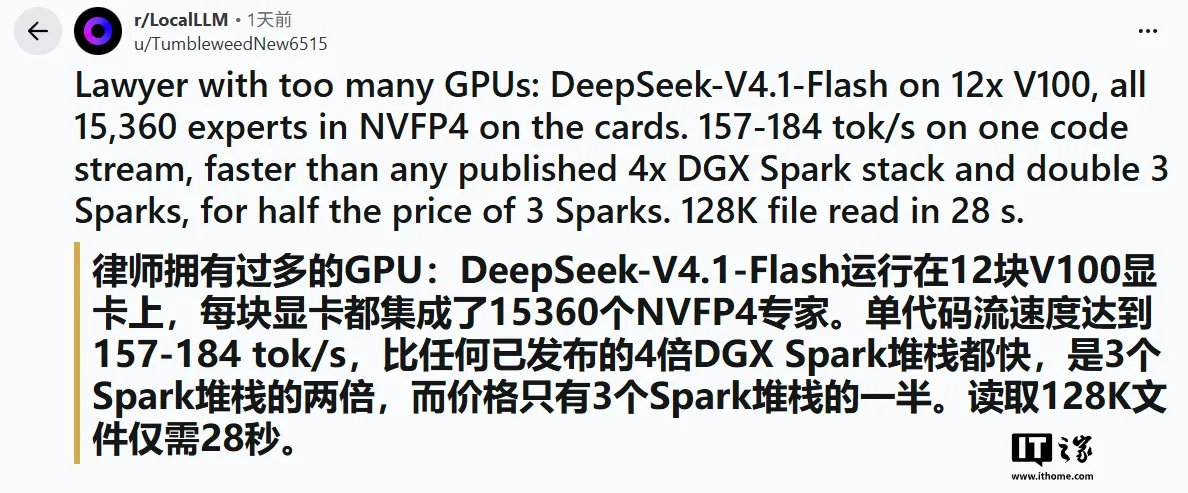
整套硬件的采购成本约为 9450 美元。作为参照,一套 3 台 DGX Spark 的组合价格约为其两倍。不过代价同样明显:满载功耗最高可达约 2100W,噪音较大,并不适合普通办公环境。发帖者自己也坦言,这并非一台批量解码引擎。
实测数据:长文本与代码是强项
这位律师公布了一组不同上下文长度下的测试数据,涵盖首个词元延迟、预填充速度,以及代码、法律、普通文本三类任务的生成速度。
| 上下文长度 | 首个词元(冷启动) | 预填充速度(词元/秒) | 代码 | 法律 | 普通文本 |
|---|---|---|---|---|---|
| 1K | 0.7 秒 | 1567 | 184 | 102 | 86 |
| 8K | 2.5 秒 | 3267 | 176 | 93 | 90 |
| 32K | 7.3 秒 | 4478 | 176 | 92 | 95 |
| 64K | 13.9 秒 | 4697 | 157 | 93 | 83 |
| 128K | 28.1 秒 | 4670 | 157 | 93 | 86 |
| 256K | 58.0 秒 | 4518 | 153 | 92 | 85 |
从数据看,上下文达到 128K 时,读取一份长文档仅需约 28 秒;即便扩展到 256K,首个词元的冷启动等待也不到 1 分钟。三个代码请求合计的生成速度在不同上下文下保持在 364 至 600 词元/秒区间;在文档已缓存的情况下,首个词元延迟可低至 0.2 至 0.6 秒。
在与同类方案的横向对比中,这套 12 卡 V100 系统表现如下:
| 对比项 | 3× DGX Spark | 4× DGX Spark | 12× V100(本次配置) |
|---|---|---|---|
| 单请求,代码 | 125(SGLang)/ 138(TensorFold)/ 136(vLLM) | 未发布 | 153–184 |
| 单请求,普通文本 | 38–51 | 79–88 | 83–95 |
| 预填充,长提示词 | 约 2000 | 3100–8500(因方案而异) | 4500–4700 |
| 多请求 | 4 个流合计 85 | 最高 570(16 个流) | 344–443(3 个流) |
| 上下文 | 配置 256K | 1M | 配置 524K |
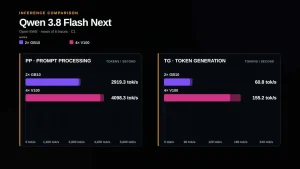
发帖者称,在单请求、单流场景下,这套服务器优于已公开的 4 台 DGX Spark 组合:代码生成速度快约 15% 至 45%,普通文本生成速度也更高。不过在多流并发场景中,4 台 DGX Spark 在部分配置下仍能达到更高的合计吞吐。
二手卡的性价比逻辑,值得借鉴吗
这起案例的价值,不在于人人都要去组装一台 2100W 的”电老虎”,而在于它展示了消费级和二手商用硬件运行大模型的可行性边界。对于需要本地部署、又受限于预算的用户,几条经验值得参考:
其一,量化是降低硬件门槛的关键。4bit NVFP4 让原本需要海量显存的模型得以在有限显卡上分片承载;其二,MoE 架构的专家分片机制,使得多卡协同成为可能;其三,长上下文场景对预填充性能的要求,往往比单纯看生成速度更重要——这正是这套系统的强项。
但也要看到局限。二手 V100 缺乏官方质保,功耗与噪音使其在家庭或办公室环境中难以部署;相关性能数据均来自发帖者自测,尚未经过标准化基准的独立验证,不同模型与量化方案下的表现也会有差异。对大多数用户而言,直接选用更新架构的显卡或云端服务,可能仍是更省心的方案。
信息来源:IT之家、Reddit 社区 r/LocalLLM、Tom’s Hardware。文中性能数据为发帖者自测结果,未经独立第三方验证。