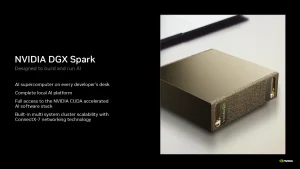
英伟达在德国柏林举行的 GTC 2026 大会上,对面向个人与小型团队的桌面级人工智能超算 DGX Spark 做出多项重要更新:将设备集群规模从原先的最多 4 台提升至 8 台,并同步推出本地人工智能平台软件升级,以及与开源社区联合优化的推理性能方案。
集群规模翻倍,统一内存冲上 1TB
英伟达此前已为 DGX Spark 提供最多 4 台设备组建集群的能力,本次更新开放了手动配置最多 8 台设备组建集群的选项。若采用 128GB 内存版本进行组建,整套集群的统一内存容量最高可达 1TB,显著降低了本地运行大参数模型时的内存压力。
推理性能最高提升 40%
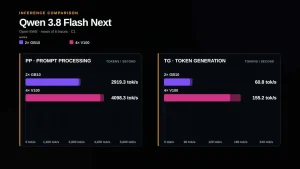
在本地人工智能平台层面,英伟达宣布与 llama.cpp、vLLM 两个开源社区合作,对人工智能推理性能进行针对性优化。官方给出的数据显示,在特定工作负载下,RTX PRO 6000 Blackwell 的推理性能最高提升 40%;DGX Spark 与定位更高的 DGX Station 也分别获得最高 30% 和 20% 的性能提升。
具体到推理框架,在 llama.cpp 中,针对 Qwen 3.8 Flash Next 的多词元预测(MTP)推测解码优化,可使 RTX PRO 6000 Blackwell 上的端到端智能体任务提速最高 1.4 倍;在 vLLM 中,针对 Qwen3.8 27B 的推测解码与 FlashInfer 预填充内核优化,可使 DGX Spark 上的相关任务提速最高 1.3 倍;DGX Station 运行 GLM 5.3 Flash 时,吞吐量最高可提升至原来的 1.2 倍。
64GB 版本 10 月 23 日开售
英伟达表示,定价 4,999 美元(按当前汇率约合 33,450 元人民币)的 DGX Spark 64GB 版本,将于 10 月 23 日起通过合作伙伴陆续发售。面向集群部署,英伟达 Sync Model Launcher 计划于本月晚些时候上线,用户可通过该工具下载与硬件配置相匹配的模型和容器,并将模型连接至 OpenCode;工具还会自动加载 DGX Spark Skills,为设备故障排查、维护及工作流程提供指导。
软件方面,10 月版 DGX Spark 更新加入了 Wi-Fi 助手,允许设备在设备模式(appliance mode)下切换无线网络;DGX Spark Skills 也将通过 OpenCode 集成至英伟达 Sync,为日常维护和故障排查提供支持。
本地模型阵营持续扩容
模型支持上,英伟达宣布新增一批可在本地运行的 AI 模型,涵盖智能体、编程、图像生成与编辑等任务,包括 Nemotron、GLM、DeepSeek、Qwen、MiniMax 以及 FLUX.3 Klein 等。
针对本地人工智能硬件,英伟达还推出名为 Recursive Flint 的编程模型,采用混合专家(MoE)架构,总参数量 400 亿,激活参数量 25 亿。官方称其在配备 64GB 内存的 DGX Spark 上推理速度超过每秒 220 个词元。
为缓解本地运行大模型的内存压力,英伟达发布了一组优化内存占用的模型检查点,通过量化降低显存需求,同时尽可能保持接近全精度模型的准确性。其中,Qwen3.8-Flash-Next-FP4-Local 可在单台 128GB DGX Spark 或 RTX PRO 6000 上运行;GLM-5.3-Flash-FP4-Local 则面向两台系统的配置。
企业管理与机器人工作流
DGX Station 的企业管理与应用扩展计划同步公布,新增 Absolute Security、思科旗下 Splunk、Microsoft Intune、Tanium 等七项管理集成,帮助企业部署和管理本地人工智能基础设施。面向 Windows 的 DGX Station 版本预计于 12 月推出,将支持制造业相关应用,以及设计、仿真、验证和工程自动化工作流。
此外,英伟达计划为 DGX Station 推出开源的机器人参考工作流,并以早期访问形式提供 NVIDIA Cloud Functions,让团队通过统一接口共享本地模型服务。对于希望在本地构建人工智能工作负载的开发者和企业而言,DGX Spark 与 DGX Station 正从单一硬件,逐步演进为一整套覆盖模型获取、推理优化与运维管理的本地人工智能平台。