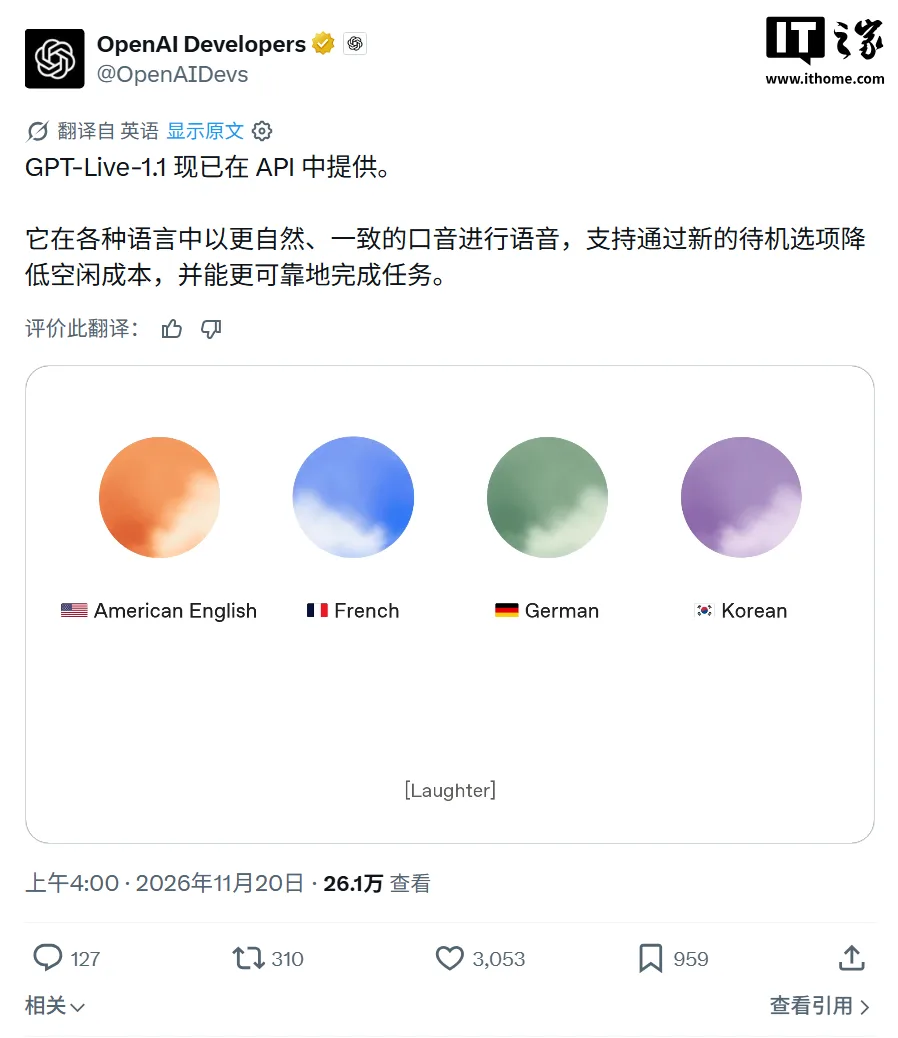
2026 年 11 月 19 日,OpenAI 在官方 API 更新日志中上线 GPT-Live-1.1,模型 ID 为 gpt-live-1.1,仅通过 v1/live/sessions 端点调用。这款全双工语音模型此前已自 10 月 15 日起成为 ChatGPT Plus 及 Pro 订阅用户的默认语音引擎,此次开放意味着第三方开发者也能把”边听边说”的实时语音能力接入自己的应用。
全双工:不必等用户说完才开始处理
传统语音助手多采用串行链路:先把语音转成文字(STT),交给大语言模型(LLM)理解,再把结果合成语音(TTS)播放。三段串联难免产生停顿感,用户必须说完一句、等机器反应。
GPT-Live-1.1 采用全双工架构,直接处理输入与输出音频,可以一边聆听一边说话,不必等用户讲完完整句子。模型能够识别说话过程中的停顿、打断和语速变化,实时判断应当继续聆听还是作出回应。OpenAI 表示,相较前代 GPT-Live-1,新版本在多语言场景下的转写更准确、口音与音色更一致,对字母、数字等需要精确识别的信息也更可靠。
后台委派:聊天与干活同时进行
真正值得注意的是”委派”设计。GPT-Live 负责语音对话这一层,把需要深度推理或工具调用的任务交给后端模型处理。开发者有两种选择:一是 Responses 委派,直接调用 OpenAI 的后端模型;二是客户端委派,接入自有的模型、智能体框架或服务。
关键在于,后端模型执行复杂任务时,语音对话不会中断。这让用户可以在等待多步骤工作流完成的同时继续交谈——比如一边查询订票结果,一边和智能体讨论行程细节。语音会话支持流式传输与函数调用,但不支持图像、视频输入。
待机模式:静默时按 0.02 美元计费
本次更新中,对成本影响最大的其实不是模型迭代,而是一项计费变化。此前语音会话无论是否在说话,都按每分钟 0.05 美元的统一费率计费。新增的待机(standby)模式下,静默时段按每分钟 0.02 美元计费,降幅约六成。
待机仅适用于 WebRTC 会话,配置涉及三个参数:wake_policy.type 设为 speech,让会话等待语音而非连接即开始推理;idle_timeout_s 取 5 至 60 的整数,代表多久没有输入输出文字记录后进入待机;wake_policy.vad_threshold 取值 0 至 1、默认 0.5,数值越高越不容易被环境噪声唤醒。会话进入待机后连接与会话 ID 保持不变,有人说话时恢复并还原对话历史。
| 项目 | 说明 |
|---|---|
| 模型 ID | gpt-live-1.1 |
| 调用端点 | v1/live/sessions |
| 活跃计费 | 0.05 美元/分钟 |
| 待机计费 | 0.02 美元/分钟 |
| 静默超时 | 5–60 秒可调 |
| 语音数量 | 21 种命名音色 |
| 委派方式 | Responses 委派 / 客户端委派 |
以一次 10 分钟、其中 6 分钟处于静默的通话为例:若这 6 分钟全部进入待机,费用约 0.32 美元,而非统一费率下的 0.50 美元。需要说明的是,后端模型与工具调用另行计费,且 GPT-Live-1.1 相较前代的提升属于官方定性描述,OpenAI 并未公布词错误率等量化基准。
常见问题
问:GPT-Live-1.1 适合做什么?
答:电话客服、应用内语音助手、车载语音交互等需要自然打断、长时间保持连接的场景,尤其是静默占比较高的电话智能体。
问:旧应用怎么迁移?
答:在现有 Live 会话配置中把模型名改为 gpt-live-1.1 即可,端点与鉴权方式不变。
问:待机一定省钱吗?
答:不一定。若间隔长到应用可以主动断开,官方文档建议直接关闭会话、用户返回时新建;待机更适合需要保留上下文的短时静默。
信息来源
本文事实依据 OpenAI 官方开发者更新日志与模型页、IT之家 2026 年 11 月 20 日报道,以及 i10X、SULAT、OrcaRouter 等科技媒体的交叉核对整理。