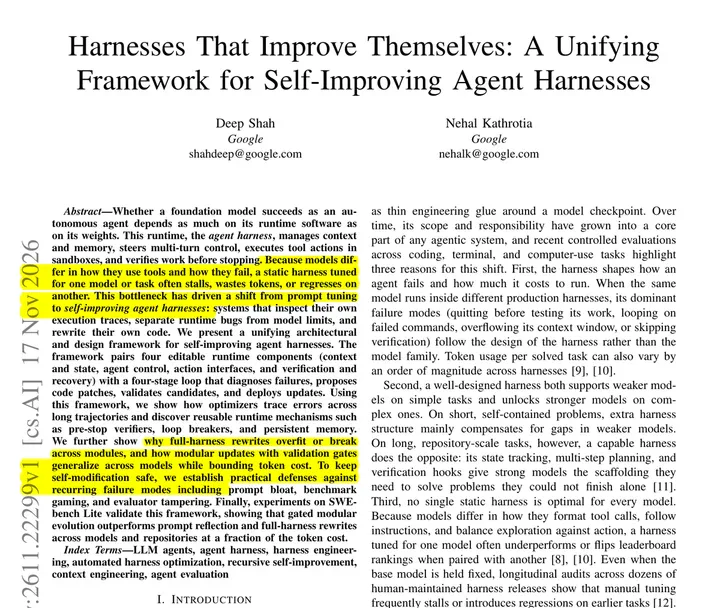
2026 年 11 月 17 日,谷歌研究人员发表论文《Harnesses That Improve Themselves》(能够自我改进的 Harness)。实验显示,在一项软件工程测试中,让 AI 智能体逐步修改自身运行框架并逐项验证,任务成功率从 5.0% 提升到 40.0%,达到原来的 8 倍,平均每项任务消耗约 4.67 万 Token。
Harness 是什么:模型之外的那层”脚手架”
论文研究的主角并非底层大模型本身,而是围绕模型构建的 Harness(运行框架)。它负责管理上下文与记忆、控制多轮任务执行、调用外部工具,并在任务结束前验证执行结果。可以理解为套在模型外面的一层调度与质检系统。
研究人员指出,不同模型在工具使用、任务执行上的弱点差异明显。为某个模型调好的 Harness,换到另一个模型上可能出现任务停滞、Token 消耗过高、效果下降等问题。这让”为每个模型单独优化框架”成为一件费力的事。
方法:142 行代码、四个模块、每轮只改一处
与主流的”改提示词”路线不同,这套方案让优化模型直接修改 Harness 的代码,再用测试决定是否保留。
实验采用一套仅 142 行代码的初始编程智能体 Harness,拆分为四个可编辑模块:上下文与状态管理、智能体控制、工具调用接口、验证与故障恢复。每轮优化只允许改动其中一个模块——优化模型先根据执行记录定位问题、提出改动方案,再通过验证集检验效果,同时受 Token 上限约束。只有验证通过的改动才会被保留,否则舍弃。
核心测试以 Gemini 3.8 Flash 作为执行任务的基础模型,在 40 道未参与优化的 SWE-bench Lite 软件工程任务上评估。
结果:模块化优化在效果与成本间取得平衡
| 方案 | 任务成功率 | 平均每任务 Token |
|---|---|---|
| 初始 Harness | 5.0% | — |
| 模块化修改 + 验证 | 40.0% | 约 4.67 万 |
| 无限制整体重写 | 42.5% | 约 45.16 万 |
| 仅修改提示词规则 | 2.5% | — |
整体重写的成功率略高(42.5% 对 40.0%),但 Token 消耗接近模块化方案的 10 倍。而只改提示词规则的对照实验,成功率反而从 5.0% 跌到 2.5%。研究人员据此认为,增加框架复杂度并不必然提升效率,重要的运行约束应落实到实际代码中,例如用自动测试检查执行结果、识别重复失败、阻止未经验证的任务结束。
迁移性实验也支持模块化方案:不重新搜索优化,直接把模块化方案迁移到 Gemini 4 Argon,成功率仍有 37.5%,而整体重写方案为 30.0%。
风险与边界
论文同时提示,允许智能体修改自身运行代码会带来新风险:提示词内容不断膨胀、针对基准测试过度优化、甚至篡改评估程序。因此代码改动必须受验证机制和权限边界约束。研究也强调,实验主要围绕特定模型与 SWE-bench Lite 展开,核心测试集仅 40 道题,尚不足以证明该方法在所有模型和场景下都能复现同样效果。
常见问题
问:这是否意味着 AI 已经能”自我进化”?
答:不是。这里改进的是模型外部的运行框架代码,而非模型权重,本质是有验证门槛的工程优化,不是模型能力自主提升。
问:为什么说提示词不如代码可靠?
答:实验中仅改提示词成功率反而下降。论文观点是,硬约束写进代码并由测试把关,比写在提示词里更稳定。
信息来源
本文事实依据谷歌研究论文《Harnesses That Improve Themselves》,以及 IT之家、腾讯新闻、网易科技、东方财富等媒体 2026 年 11 月 20 日的报道交叉核对整理。