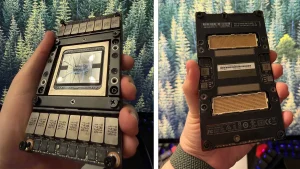
YouTube 频道 Jun Yamog 于 10 月 12 日发布视频,展示将 4 张英伟达 Tesla V100 显卡安装于 NVLink 载板后,在 Qwen3.8-Flash-Next 基准测试中的表现:长提示处理速度较 M5 Ultra 快 230%,较 2 台 DGX Spark 快 40%。
公开资料显示,Tesla V100 是英伟达于 2017 年推出的数据中心 GPU,基于 Volta 架构,常用于 AI 训练与推理。其 32GB 版本配备 HBM2 显存,显存带宽达 900GB/s,可支撑大模型参数与数据的快速读取。
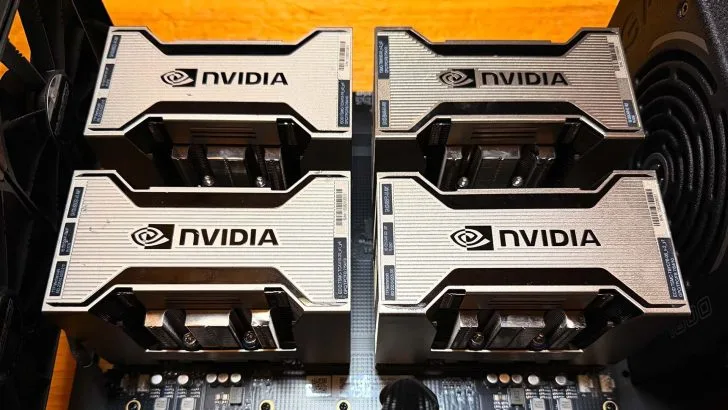
NVLink 是英伟达的 GPU 高速互联技术,用于多颗 GPU 之间的直接数据传输,相比 PCIe 通信可降低互联瓶颈。该测试所用载板提供 300GB/s 带宽,配备 6 条 NVLink 2.0 连接。为容纳 4 颗独立 GPU,测试者改装了 NVIDIA A100 散热器以散发每颗 V100 约 300W 的功耗,并通过 PCIe x8 接口连接载板。
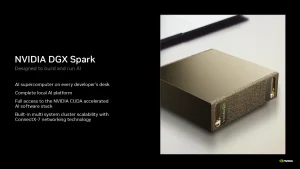
测试使用 4-bit 量化的 Qwen3.8-Flash-Next 模型,对比对象包括 2 台配备 128GB LPDDR5X 统一内存的 DGX Spark,以及搭载 M5 Ultra 芯片的 Mac Studio。
在长提示处理中,4 颗 V100 较 DGX Spark 集群快 40%,较 M5 Ultra 快 230%;测试者指出,与 Apple Silicon 的巨大差距可能部分源于软件优化不足。短提示处理中,V100 集群较 DGX Spark 保持 40% 的速度优势,较 M5 Ultra 快 163%。
短提示 Token 生成测试中,4 颗 V100 达到 100.6 tok/s,较 2 台 DGX Spark 快 121%;M5 Ultra 的成绩为 44.5 tok/s。结果表明,旧款数据中心 GPU 在特定推理负载下仍具备较高吞吐能力。