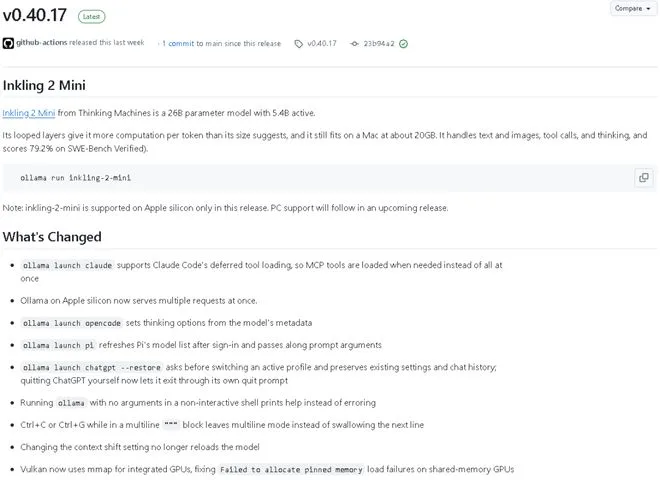
本地跑模型的体验正被一次版本更新改写。2026年11月21日,Ollama 发布 v0.40.17 稳定版,最受关注的新增是 Thinking Machines 推出的 Inkling 2 Mini:26B 总参数、每词元仅激活 5.4B,约 20GB 空间即可放进一台 Mac。本次版本涉及 11 位贡献者、26 次提交与 272 个文件变更,覆盖模型、运行时、命令行、工具调用与 API 兼容。
循环层:用重复计算换参数规模
Inkling 2 Mini 的关键设计是”循环层”。模型共 26B 参数,每次推理只激活 5.4B;同一批层被重复运行(据社区归纳,中间 24 层中的 12 层每词元运行三次),使单个词元获得比参数体量表面看起来更高的计算量。它支持文本与图像输入、工具调用和思考模式,在 SWE-Bench Verified 上得分 79.2%;在 Artificial Analysis 上与 Qwen3.8 27B 打成平手,成本约为后者六分之一。运行方式为 ollama run inkling-2-mini。
需注意,该模型本次仅支持 Apple Silicon,PC 支持将在后续版本提供。官方门槛是一台 Mac 上约 20GB——这是”装完即可运行”的日常档。社区有人把模型压到 5.38GB 跑通,但 HumanEval 得分从原模型的 92.7% 降到 70.7%;两个数字标出了”可用”与”极限压缩”的代价。
比新模型更实在的:Mac 终于能并发服务
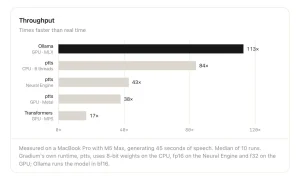
发布说明里,Apple Silicon 并发只有一句话:Ollama 现在可在 Apple Silicon 上同时服务多个请求。此前模型加载后请求串行处理——要么排队,要么再开端口加载第二份权重、内存直接翻倍。放到本地智能体场景,这条改动更贴近实际使用:后台跑总结任务,前台还能继续对话。配套的 MLX 运行器新增并发生成、批量推测验证、跨请求槽位复用已保存前缀、按内存压力调整历史记录。
| 更新项 | v0.40.17 具体变化 |
|---|---|
| 新模型 | Inkling 2 Mini,26B 总参/5.4B 激活,SWE-Bench Verified 79.2% |
| 并发 | Apple Silicon 支持同时服务多个请求,MLX 运行器支持并发生成 |
| 工具加载 | ollama launch claude 支持延迟加载 MCP 工具,按需载入 |
| 思考设置 | 关闭思考不再被忽略,映射到模型支持的最低推理等级 |
| API 兼容 | 工具定义保留 Ollama 未建模的 JSON Schema 关键字 |
| 显卡修复 | Vulkan 核显改用 mmap;Windows 核显部分卸载不再 KV 缓存分配失败 |
容易被忽略却关键的修复
ollama launch claude 支持 Claude Code 的延迟工具加载:用到哪个 MCP 工具才把定义送进上下文,不再是开局一次性塞满几十个工具、吃掉几千词元。改 context shift 设置不再触发模型重新加载,省去半分钟等待。API 传入的工具定义会保留未建模的 JSON Schema 关键字,利好复杂参数约束。Vulkan 后端对集成显卡改用 mmap,修复共享内存 GPU 上”Failed to allocate pinned memory”的加载失败;Windows 集成显卡部分卸载模型时不再出现 KV 缓存分配失败。
交互细节也一并打磨:非交互 shell 中不带参数运行 ollama 现在打印帮助而非报错;多行输入块中 Ctrl+C 或 Ctrl+G 可干净退出;ollama launch chatgpt –restore 切换配置前先询问,并保留已有设置与聊天记录。
值不值得升级
对已用 Ollama 跑本地智能体的用户,升级核心不是榜单分数,而是”本地部署终于能同时干两件事”——并发与 MCP 按需加载补上了相对云端的短板。对观望者,Inkling 2 Mini 提供了一台 20GB 内存的 Mac 就能上手、代码基准不俗的新选择,但需接受它暂不支持 Windows。
常见问题
Windows 用户现在能用吗? 不能。该模型在 v0.40.17 中仅支持 Apple Silicon。
20GB 是模型文件大小吗? 不是精确等同,是官方给出的”装完即可运行”内存门槛;社区压到 5.38GB 的版本得分明显下降。
信息来源
Ollama v0.40.17 官方发布说明、Thinking Machines/Hugging Face 模型卡、微信公众号技术解读(2026年11月20日至22日)。性能数据多为厂商或社区自报,不构成选型建议。