结论:微软在 2026 年 11 月 17 日 Ignite 2026 活动上宣布,第二代自研 AI 加速器 Maia 200 投入规模化生产。在 Teams、Copilot 等内置功能中,其每瓦 token 处理量较领先 GPU 基础设施最高提升 1.7 倍,标志微软自研芯片从试点走向主力推理基础设施。 关键数字:1.7 倍 / 台积电 3 纳米 / 6144 颗集群
| 参数项 | 规格 |
|---|---|
| 制程工艺 | 台积电 3 纳米 |
| 张量核心 | FP4 与 FP8 |
| 内存配置 | 216GB HBM3e + 272MB 片上 SRAM |
| 单芯片算力 | FP4 精度下超 10 petaFLOPS |
| 集群规模 | 以太网扩展至最多 6144 颗 |
| 部署区域 | 美国、欧洲、澳大利亚 |
每瓦性能提升 1.7 倍意味着什么
微软给出的对比基准是「领先 GPU 基础设施」,场景限定在 Microsoft Teams、Copilot 和 Cowork 等内置 AI 功能。1.7 倍衡量的是每瓦 token 处理量,也就是能效,而非绝对峰值算力。
换句话说,同样一度电,Maia 200 能多产出约七成的生成内容。对需要 7×24 小时运转的大规模推理服务而言,能效提升会随时间放大成可观的运营成本节约。
值得注意的是,微软并未点名对标的 GPU 具体型号,1.7 倍属于厂商自述数据,实际表现仍需等更多独立测试验证。
一颗芯片堆了多少料
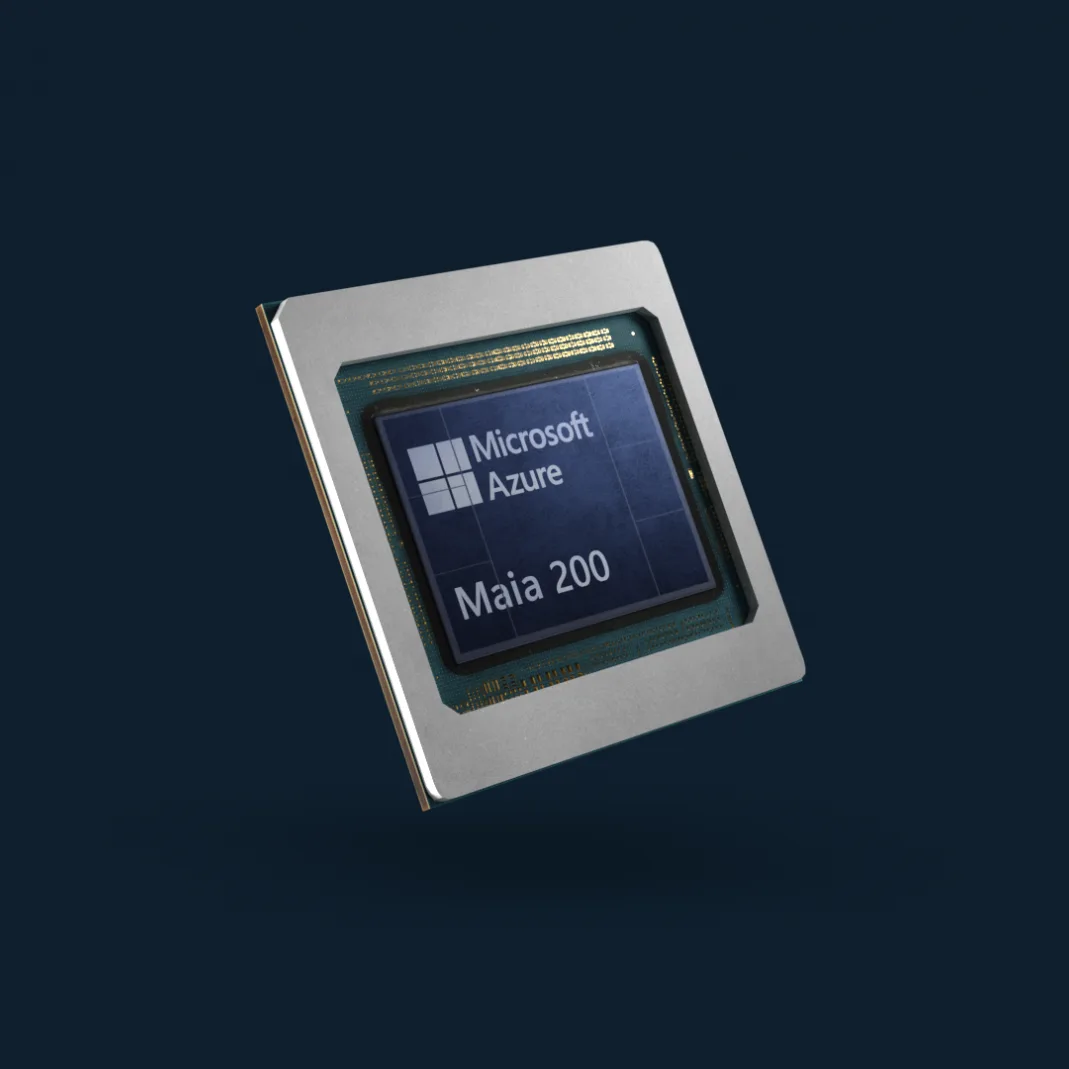
Maia 200 面向 AI 推理设计,采用台积电 3 纳米工艺,配备 FP4 与 FP8 张量核心、216GB HBM3e 内存和 272MB 片上 SRAM。
单颗芯片在 FP4 精度下可提供超过 10 petaFLOPS 算力,并可通过以太网扩展至最多 6144 颗加速器组成的集群。FP4 是一种低精度数字格式,以精度换速度,推理场景更省电;大容量片上 SRAM 则有助于减少推理时的数据搬运开销。
从三大洲到多吉瓦的落地节奏
Maia 200 已部署于美国、欧洲和澳大利亚,服务于 Microsoft Copilot 等生产工作负载,并将逐步支持 GitHub Copilot 与 Microsoft Foundry。
微软计划在 2027 年把 Azure Maia 系统扩展到多吉瓦级部署,使其成为微软产品与服务的主要推理基础设施。从 2023 年第一代 Maia 发布到如今规模化量产,微软走完了从试水到上量的阶段。
这意味着算力竞赛已进入能效比拼阶段。头部云厂商自研推理芯片,可以把硬件针对自家服务负载做定制优化,在成本、能效和供应链稳定性上掌握更多主动权,但芯片设计、软件栈适配和生态建设仍需持续投入。
谁会受这颗芯片影响
对 Azure 企业客户,Maia 200 的量产意味着未来 Copilot 类服务的推理成本可能下降,服务稳定性也更可控;对开发者,GitHub Copilot 与 Foundry 逐步接入后,底层算力变化短期内不会改变调用方式。
对GPU供应商而言,这是头部客户自研替代信号的一次强化。不过 Maia 200 只面向微软自家数据中心,目前没有对外销售的安排,普通用户无法直接采购。
所以呢:自研芯片与外部采购并行的双轨模式,正成为大型云厂商的默认选择。
常见问题
Maia 200 对外销售吗?
不对外销售。该芯片用于微软自家数据中心,服务 Copilot 等生产负载。
它主要用来训练还是推理?
面向推理。Maia 200 是微软为降低单位算力成本设计的 AI 推理定制芯片。
1.7 倍的对比对象是谁?
微软表述为「领先 GPU 基础设施」,未点名具体型号,数据来自厂商自述。
信息来源:IT之家 2026 年 11 月 18 日报道,内容源自微软 2026 年 11 月 17 日 Ignite 2026 活动公布的信息。