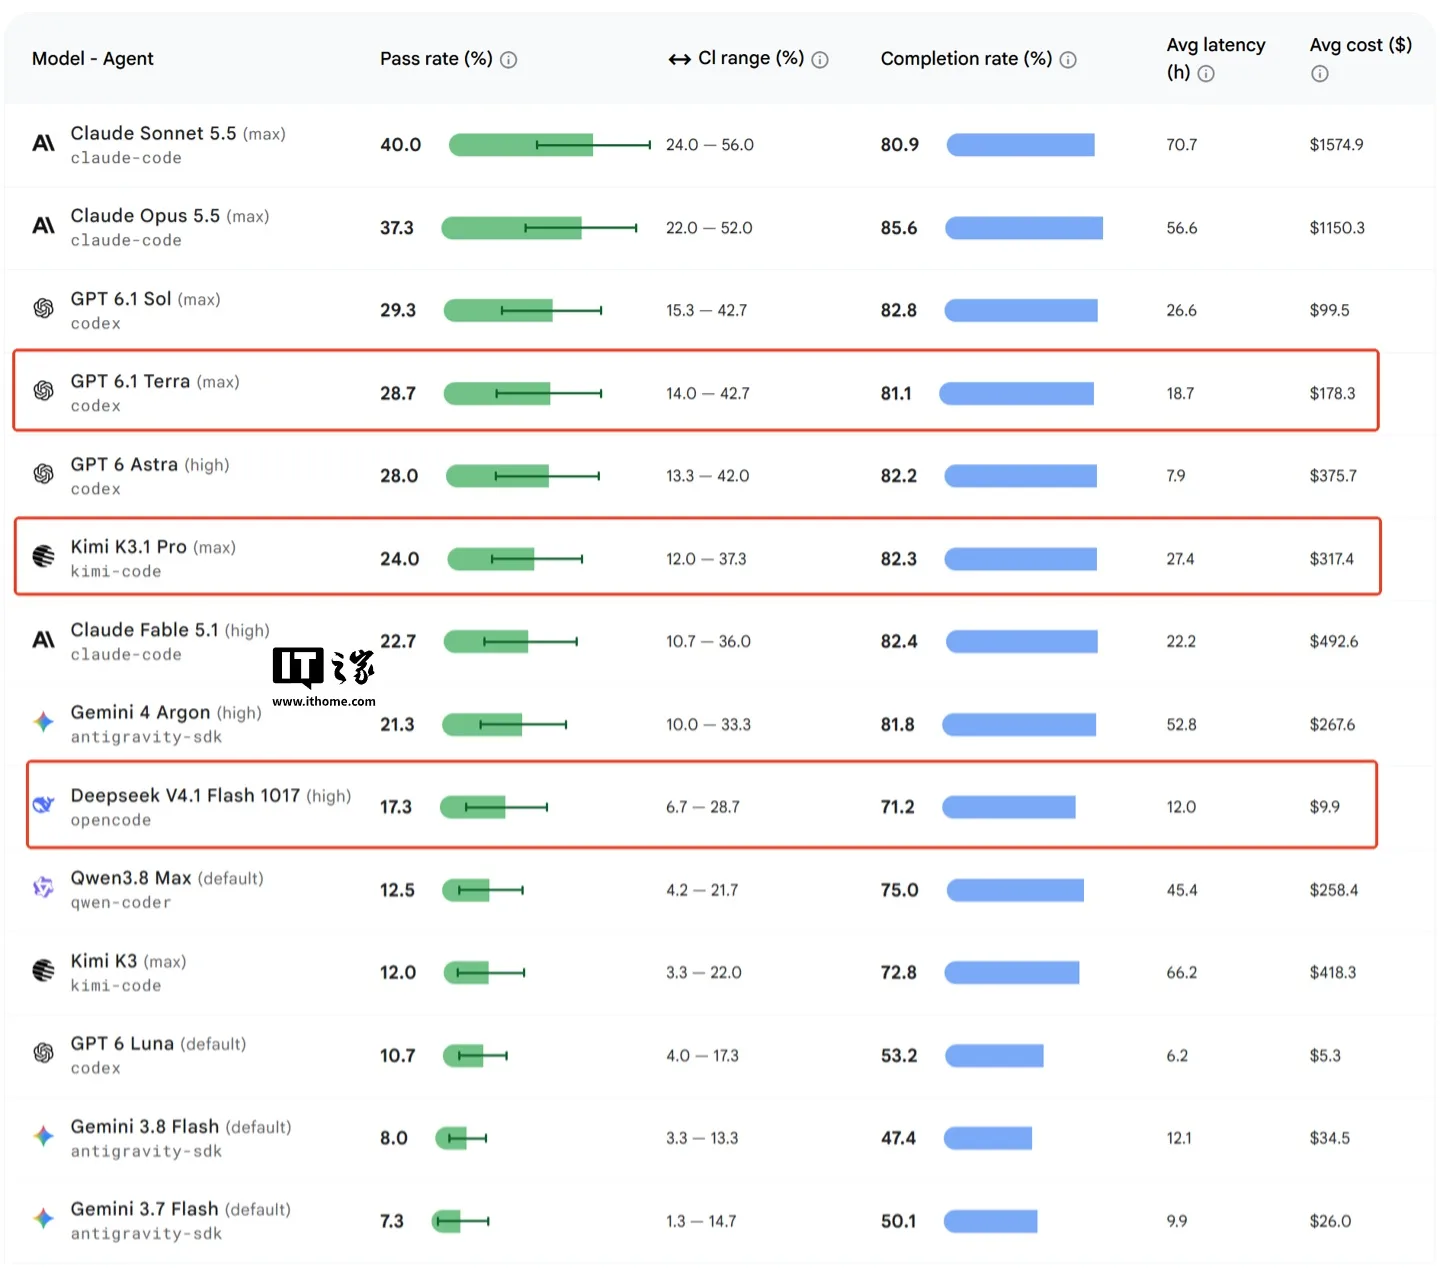
谷歌旗下 Android 开发者官方账号(@AndroidDev)于 11 月 10 日在 X 平台发文,首次公开了 OpenAI GPT-6.1 Terra、Kimi K3.1 Pro 以及 DeepSeek V4.1 Flash 三款模型在 Android Bench 基准测试中的成绩。
什么是 Android Bench
Android Bench 是谷歌面向安卓开发场景推出的 AI 编程基准,重点考察模型在应用创建、功能开发、代码迁移和应用转换等真实工程任务上的能力。该基准包含 30 项长程任务,强调模型完成完整工程目标的能力,而非单轮问答表现。
Kimi K3.1 Pro 的表现
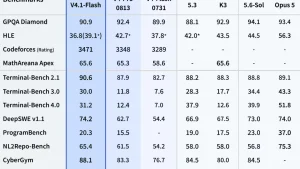
本次新增评测的 Kimi K3.1 Pro 使用 kimi-code 智能体参与测试。在 30 项长程任务中,其通过率为 24.0%,平均完成度达到 82.3%,平均耗时为 27.4 小时,单次基准运行成本为 317.4 美元(按当前汇率约合 2123 元人民币)。
横向对比来看,Kimi K3.1 Pro 的成绩高于 GPT 6 Astra、Claude Fable 5.1 以及 Gemini 4 Argon,但仍低于 OpenAI 的 GPT-6.1 Terra(通过率 28.7%)。
DeepSeek V4.1 Flash 的速度与成本优势
DeepSeek V4.1 Flash 1017 通过 opencode 智能体参与评测,取得 17.3% 的通过率、71.2% 的平均完成度、12.0 小时的平均耗时,单次基准运行成本仅 9.9 美元(约合 66.2 元人民币)。
尽管其通过率低于 Kimi K3.1 Pro,但在速度和成本上优势明显:耗时约为前者的一半,成本更是大幅降低,适合对预算和响应时间敏感的开发团队使用。
基准的参考意义
Android Bench 的公开,为开发团队在选型 AI 编程工具时提供了统一、贴近真实工程场景的参考。从结果看,头部模型的通过率仍普遍偏低,说明端到端的安卓应用开发仍是当前大模型面临的难点;而各家在成本、速度上的差异,则为不同规模的团队提供了更灵活的选择空间。