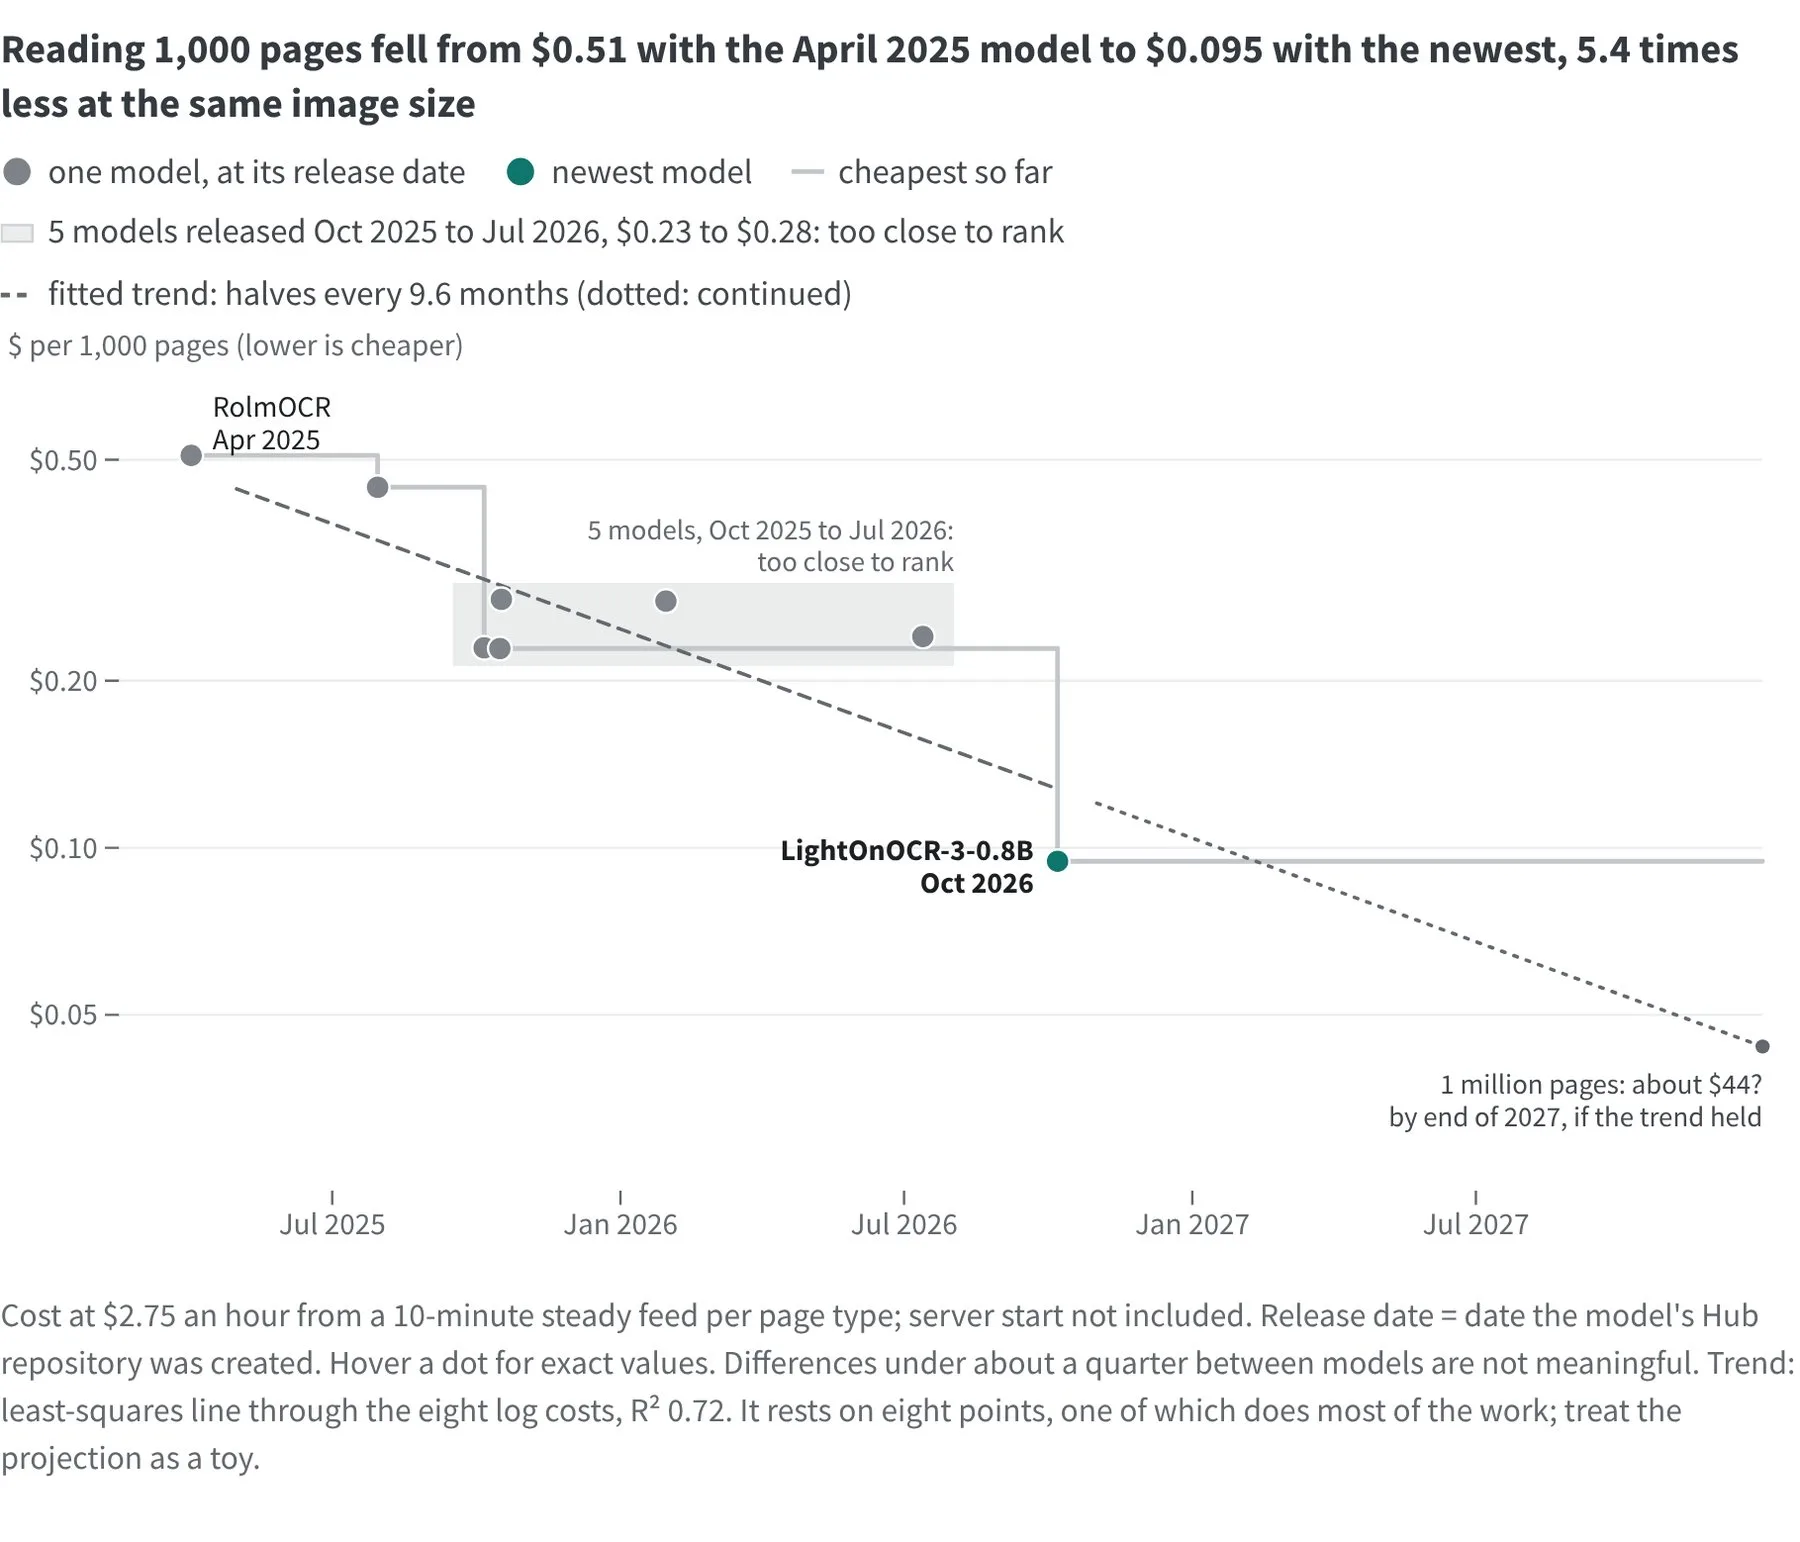
8 款开源 OCR 模型在同一块显卡上跑完 850 页历史文档后,识别 1000 页的成本从 0.51 美元降到了 0.095 美元——间隔只有 18 个月。这是 Hugging Face 的研究人员丹尼尔·范斯特里恩(Daniel van Strien)公布的对比测试结果,意味着把一百万页扫描件转成可检索文本,如今只需支付 65 至 130 美元的显卡租赁费。
测试怎么做的
范斯特里恩选取了 850 页测试材料,分为三类:旧版自然历史书籍、1771 年版《大英百科全书》,以及打字和印刷的历史档案文件。8 款模型全部跑在同一款显卡上——英伟达 RTX PRO 6000,由他通过 Hugging Face 租用,费用为每小时 2.75 美元。统一的硬件与图像尺寸,让不同模型之间的成本可以直接横向比较。
值得注意的是,中间还有 5 款在 2025 年 10 月至 2026 年 7 月间发布的模型,千页成本集中在 0.23 至 0.28 美元区间,彼此差距很小,真正拉开距离的是最早和最晚的两端。
成本与准确率结果
| 对比项 | 最早模型 RolmOCR | 最新模型 LightOnOCR-3-0.8B |
|---|---|---|
| 发布时间 | 2025 年 4 月 | 2026 年 10 月 |
| 千页识别成本 | 约 0.51 美元 | 不到 0.1 美元 |
| 百万页显卡租赁费 | —— | 约 65 至 130 美元 |
| 书籍页面准确率 | 基准 | 至少不逊于最早模型 |
结论很直接:新模型处理书籍页面的准确率至少不逊于老模型,成本却降到了约五分之一。对于需要处理海量扫描件的档案馆和数字化团队,这意味着门槛的大幅下降。
省钱的关键不只是换模型
范斯特里恩特别强调,优化模型的运行方式所节省的成本,与更换新一代模型带来的节省幅度相当,有时甚至更多。他列出的优化措施包括:让页面处理任务分配得更均衡、使用尺寸更小的扫描图像、更新软件版本,以及换用运行速度更快的显卡。
他还给出一条经验趋势:在相同图像尺寸下,成本大约每 9.6 个月减半。不过他本人也提醒,这条拟合曲线只基于 8 个数据点,其中一款模型贡献了大部分工作量,据此做的长期外推应当谨慎看待。
准确率之外的隐患
成本下降并不意味着可以高枕无忧。测试发现,部分模型会在空白页面上凭空生成文字,还有模型会反复输出相同内容。在一次针对性对比中,OvisOCR2 在 63 张空白页中的 24 张上写下了「The quick brown fox」这样与原文无关的句子。另有模型在处理被污渍遮挡的页面时,会自行编造结尾内容却不标注这是推测。这些错误不会体现在成本数字里,却可能悄悄污染数字化成果,因此空白页和稀疏页的人工复核仍然必要。
需要厘清的是,上述费用只覆盖已有扫描图像的文字识别环节,按单张显卡每小时 2.75 美元计算,不含服务器启动时间,也不包括实体扫描、人工校对等完整数字化流程的其他成本。
常见问题
问:百万页 65 至 130 美元的费用包含哪些开销?
答:仅包含在租用显卡上运行 OCR 模型的费用,具体金额因原始材料类型而异,不含实体扫描、人工校对和完整数字化服务的成本。
问:换用最新模型就一定更省钱吗?
答:不一定。范斯特里恩指出,优化运行方式(均衡分配任务、缩小扫描图、更新软件、换更快显卡)带来的节省幅度与换模型相当甚至更高,单独更换模型只是成本方程的一部分。
问:最便宜的模型准确率如何?
答:最新模型处理书籍页面的表现至少不逊于最早模型,但部分模型存在空白页生成文字、重复输出等问题,需要针对性复核。
信息来源
来源:IT之家、The Decoder、Daniel van Strien 公开测试结果。原文链接:https://www.ithome.com/1/029/688.htm