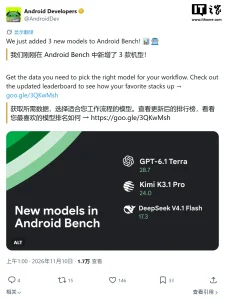
结论:谷歌 2026 年 11 月 10 日在 X 平台公布 Android Bench 安卓 AI 编程基准,Kimi K3.1 Pro 长程任务通过率 24.0%、单次运行成本 317.4 美元,DeepSeek V4.1 Flash 单次成本仅 9.9 美元。 关键数字:Kimi 通过率 24.0% / DeepSeek 成本 9.9 美元 / GPT-6.1 Terra 28.7%
| 模型 | 长程任务通过率 | 平均完成度 | 单次运行成本 |
|---|---|---|---|
| Kimi K3.1 Pro | 24.0% | 82.3% | 317.4 美元(约 2123 元) |
| DeepSeek V4.1 Flash | 17.3% | 71.2% | 9.9 美元(约 66.2 元) |
| GPT-6.1 Terra | 28.7% | 官方未公布 | 官方未公布 |
Android Bench 到底考什么
Android Bench 是 Google 面向安卓开发场景推出的 AI 编程基准,重点考察模型完成应用创建、功能开发、代码迁移与应用转换等真实工程任务的能力。它不看模型会不会写代码片段,而看能不能把一整套工程任务跑到结尾。
本次公布的榜单共 30 项长程任务,覆盖应用创建、架构与库迁移、新功能开发、跨平台转换等类型,每项任务会多次运行后取平均通过率。
Kimi K3.1 Pro 强在哪、弱在哪
Kimi K3.1 Pro 使用 kimi-code 智能体参评,30 项长程任务通过率 24.0%,平均完成度 82.3%,平均耗时 27.4 小时。横向看,它的成绩高于 GPT 6 Astra、Claude Fable 5.1 与 Gemini 4 Argon,但低于 GPT-6.1 Terra 的 28.7%。
它的短板是耗时与成本:单次基准运行 27.4 小时、花费 317.4 美元,对中小团队并不友好。
DeepSeek V4.1 Flash 为什么只要 9.9 美元
DeepSeek V4.1 Flash 1017 通过 opencode 智能体参评,通过率 17.3%、平均完成度 71.2%、平均耗时 12.0 小时。通过率低于 Kimi,但速度是前者的两倍多,单次成本仅 9.9 美元。
这意味着对预算和响应时间敏感的团队,DeepSeek 的性价比明显更高,只是结果质量要打一定折扣。
对开发团队而言,这份榜单的价值在于把“模型能不能写完工程”量化出来。Kimi K3.1 Pro 适合追求完成质量、预算充足的长周期项目;DeepSeek V4.1 Flash 适合预算紧、要快速出原型的中小团队。值得注意的是,两款模型使用了不同智能体(kimi-code 与 opencode),榜单并非严格同口径对比,结论不能直接套用到其他调用方式。
常见问题
Android Bench 是什么
Android Bench 是 Google 推出的安卓 AI 编程基准,用 30 项真实工程任务衡量模型完成应用开发与迁移的能力。
Kimi 和 DeepSeek 谁更适合个人开发者
预算有限、追求速度的个人开发者更适合 DeepSeek V4.1 Flash,单次成本仅 9.9 美元;追求完成质量则选 Kimi K3.1 Pro。
这个榜单能代表真实开发水平吗
只能作参考。榜单用不同智能体跑分,且任务固定,不代表模型在自由开发环境下的真实表现。
信息来源:IT之家 2026 年 11 月 11 日报道,谷歌 Android Developers 官方 X 账号 2026 年 11 月 10 日发布。