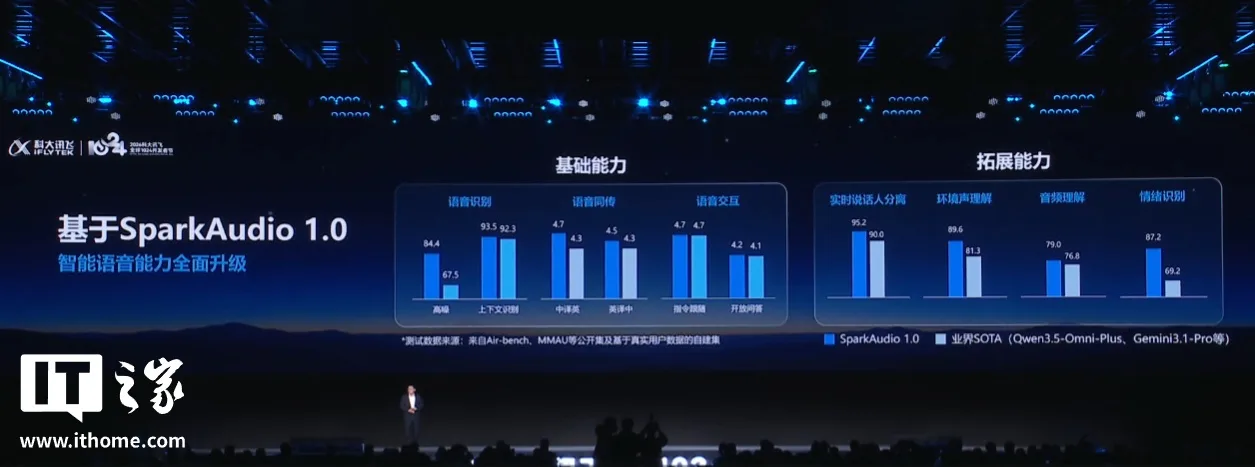
在近日举行的科大讯飞全球 1024 开发者节上,科大讯飞正式发布星火语音基座大模型 SparkAudio 1.0。这款模型将机器翻译、语音识别与语义理解等多项能力整合到统一的语音基座之中,被官方定位为面向物理世界应用的新一代语音能力底座。
从”听懂字句”到”理解场景”
SparkAudio 1.0 在实时说话人分离、环境理解、音频理解与情绪识别等维度被官方评价为”表现卓越”。在发布会现场,科大讯飞通过一段电影片段的实时分析,展示了模型对声音内容、背景环境、说话人性别等信息的精准识别,以及对所处场景的判断能力。这意味着语音交互不再局限于逐字转写,而是开始具备对声音背后情境的理解。
已落地四大产品线
据官方介绍,SparkAudio 1.0 已在讯飞输入法 16.0、讯飞听见、讯飞办公本与讯飞翻译机全面上线,支持中英文任意切换与说话人实时识别。在跨语言交流、会议记录与多语种转写等场景中,用户可以在不手动切换语种的情况下,连续完成中英文混合内容的识别与翻译。
配套硬件:讯飞 AI 录音环
与模型同期亮相的还有一款名为”讯飞 AI 录音环”的硬件设备。该设备搭载 4+1 环麦阵列,支持 Wi-Fi 6 传输,官方宣称综合识别准确率超过 96%;在录音转写效率上,完成 2 小时的录音转写仅需约 2 分钟。结合 SparkAudio 1.0 的语音能力,这款设备面向会议、访谈等需要快速成稿的场景。
语音大模型竞赛升温
将语音识别、翻译与语义理解统一到单一基座模型,正成为头部人工智能厂商的共同方向。对于中国市场而言,多语种、多方言以及中英文混合场景的识别能力,是语音技术落地办公、教育与政务等领域的关键门槛。SparkAudio 1.0 的发布,显示出科大讯飞在语音这一传统优势赛道上继续加码基座化、平台化的投入。