(导语)OpenAI 10 月 2 日发布 GPT-6 系列模型使用指南,面向开发者和用户介绍如何根据工作负载选模型、写好提示词、管理推理强度,从而在控制时间和成本的同时充分发挥模型能力。
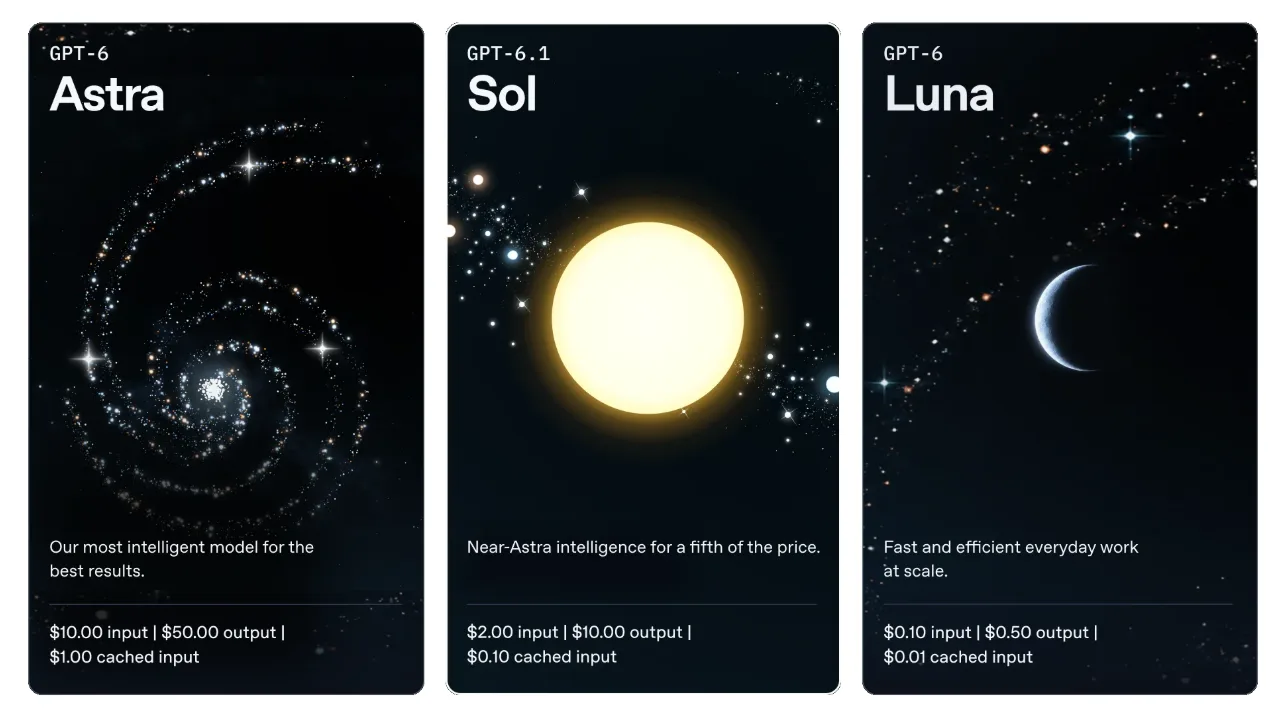
三款模型各有定位
OpenAI 在指南中推荐用户根据工作负载选择模型,不必默认使用”最强”模型——简单任务用轻量模型通常更快、更便宜。
GPT-6 Astra 面向需要最高智能水平、难度最大的推理工作;GPT-6.1 Sol 适合复杂编程、研究与计算机操作任务,并可在 Responses API 中以测试形式支持多智能体工作流,将独立子任务分派给子智能体后再汇总结果;GPT-6 Luna 则适合大规模、目标明确的日常重复性工作,例如提取发票字段、对请求进行分类,或生成结构化摘要。
提示词要讲清”要什么”
在提示词优化方面,OpenAI 认为,与其写冗长的步骤,不如先说清”我想要什么结果、给谁用、有什么不能改”。官方建议用户在输入提示词时,明确目标、受众、相关上下文、限制条件以及”什么算完成”,同时说明模型可自行决定什么、何时需要征求用户意见。
推理强度不必拉满
在推理强度方面,OpenAI 表示日常问答不必追求最高推理强度,只有复杂分析、调试或深度研究才值得升级。据其他媒体整理,推理档位分为低、中、高及更高数档:低档适合提取事实、小幅修改等常规任务;中档适合功能规划、方案比较等需要判断的工作;高档用于疑难调试、深入分析;更高档位仅在低档仍不敷使用时测试。
速度上,API 中的 Fast 模式适合对话与编码工具等对响应时延敏感的场景,Ultrafast 目前面向 Astra 提供,可独立于推理档位加快 token 生成。
用缓存把成本降下来
在上下文与成本控制上,指南建议把稳定指令与参考资料放在会变化的任务细节之前,并保持工具定义一致,以便复用提示缓存。OpenAI 称,缓存的输入 token 成本最高可比未缓存输入低 95%。对于长对话,可用压缩机制在保留续接所需状态的前提下缩减上下文。
对于跨时长任务,用户可通过 WebSocket 接口在模型工作过程中中途纠偏,更新会排队执行,不会取消正在运行的工具或撤销已完成的操作;异步工具调用则让模型在应用执行较慢任务时继续独立工作。
IT之家附上的参考地址为 GPT-6 系列模型指南。