11 月 11 日,在 Adobe MAX 大会上,Adobe 公布了最新一批仍处于实验阶段的”Sneaks”项目。这些功能尚未正式推出,但展示了 Adobe 在生成式 AI 上的探索方向:把照片编辑、视频制作和音频混音等复杂流程,变得直观、互动且门槛更低。
Project Screen Test:像试镜一样设计 AI 角色
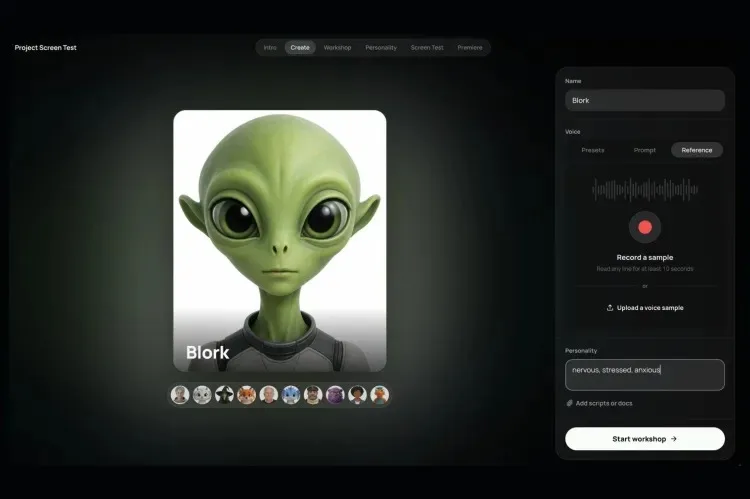
Project Screen Test 旨在让用户更轻松地创建可用于视频内容的 AI 生成角色。与传统方式不同,用户不再只是用文字提示词描述角色”如何说话、如何表现”,而是可以直接与角色对话,在类似演员试镜的环境中对其进行指导。
使用时,用户先描述角色的基本性格特征(例如”焦虑、害羞、笨拙”),并设置声音——声音可从预设选项选择,也可以通过文字描述,或上传一段音频样本让 AI 参考。随后,用户可像通过 FaceTime 视频通话一样与 AI 角色对话,完善其成长背景、性格、目标、缺点、恐惧,以及独特的动作习惯等设定。完成后,还能生成相应的动态试镜视频。
Project Sight Span:把平面照片变成可探索的 3D 空间
Project Sight Span 能将普通照片和图片转换为可供用户探索的 3D 空间,重新调整构图与视角。它可以生成原始画面之外的物体和背景,把一张平面图片扩展成完整的三维环境;即使用户转动视角、查看原本被遮挡的背后区域,系统生成的内容也能与原始画面自然衔接。
在 3D 环境中浏览时,物体和背景会显得像素化、细节不足;但当用户选定最终视角后,系统会恢复该画面的分辨率。Sight Span 支持照片、绘画和插画,并能保留原作品的艺术风格,被形容为苹果 Spatial Reframing 空间重构功能的”强化版”。
Project Sound Bender:用文字指挥音效混音
Project Sound Bender 是一项 AI 音频混音功能。用户上传一段视频,并用文字描述想要的声音效果(例如”冒着气泡的科幻炼金锅声音”),Sound Bender 便会自动生成相应音效并与之同步。
工具还提供一个方形声音控制面板,四角会自动分配不同类型的 AI 生成声音,例如密集的咕噜声和气泡爆裂声、岩石沸腾般的轰鸣、带音高变化的电子音,以及噼啪作响的电火花声。用户可在面板上拖动光标,自由选择希望突出的声音类型。
Project Rinse Repeat:编辑操作一键复用到全图
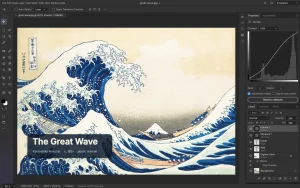
Project Rinse Repeat 能让用户复制已完成的编辑操作,并自动应用到同张照片中的其他人物或物体。例如,用户为照片中某个人物磨皮、去除痘痘和瑕疵后,Rinse Repeat 可根据已完成的具体修改,自动将类似处理应用到合影中的其他人。
该功能也可用于商业营销图片:为产品添加阴影效果时,即使其他产品形状和尺寸不同,系统也能自动适配相应阴影。它基于 Photoshop 构建,且应用到其他对象上的效果仍完全可编辑——工具会调用 Photoshop 原生功能重建修改,而非简单覆盖处理后的图像。
值得关注的信号
这些 Sneaks 项目目前都只是技术预览,未来是否、以及如何整合进 Creative Cloud 或 Firefly 平台尚未确定,也不保证全部正式推出。但 Adobe 资深首席研究科学家 Gautham Mysore 在接受 The Verge 采访时表示,让交互更直观,同时也是为了让经验丰富的创作者获得更精准的控制能力。
无论这些工具看起来多么新奇,它们释放出一个信号:如果足够实用,AI 未来可能取代创意专业人士目前使用的部分工具与素材库。