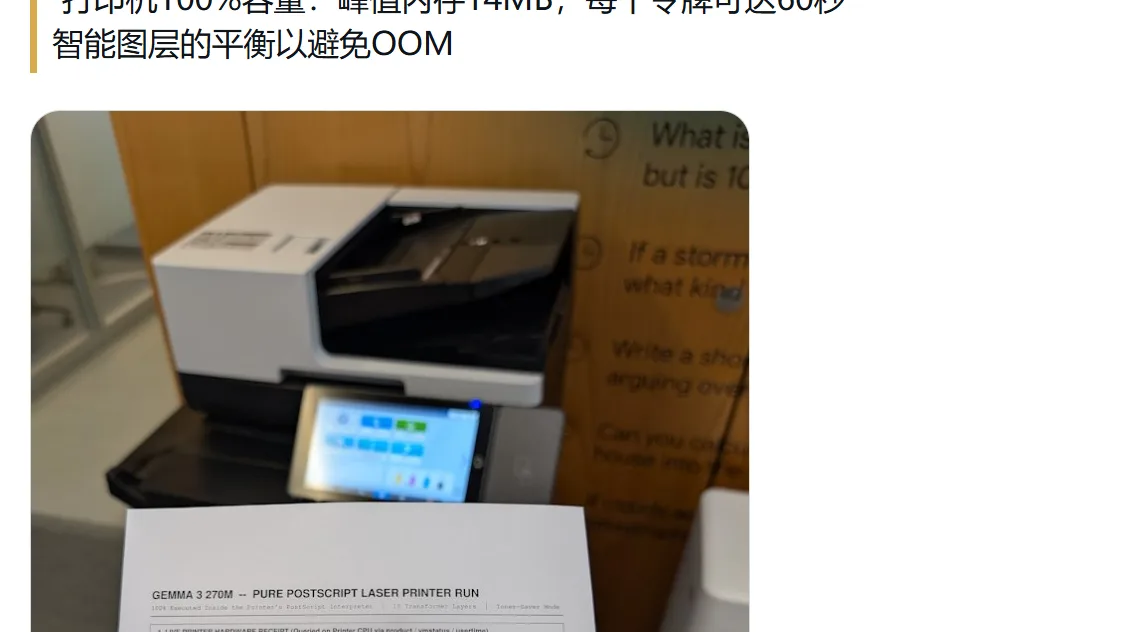
一台普通办公激光打印机,内存只有约 14MB,却跑起了 2.7 亿参数的语言模型。这不是科幻设定,而是谷歌 DeepMind 技术团队成员奥马尔·圣塞维耶罗(Omar Sanseviero)在 2026 年 11 月 17 日于社交平台 X 上公布的一次真实实验:让打印机用内部 CPU 执行推理,最终把答案直接打印在纸上。代价是速度——每输出一个词元,大约要等 60 秒。
一台打印机怎么跑起大模型
这次实验的主角是一台理光(Ricoh)办公激光打印机,跑的模型是谷歌的 Gemma 3 270M,参数量为 2.7 亿。圣塞维耶罗借助谷歌的 Gemini 4 Carbon 模型,把一个小型 Transformer 推理引擎连同量化后的模型,一起编译成了一份 PostScript 打印任务。
关键在于,实验全程没有修改打印机固件,也没有加装任何外部计算板。它利用的是打印机内置的 PostScript 解释器——这门原本用来描述页面长什么样、该打印什么内容的语言,被拿来承担了运行神经网络的工作。整个计算过程都发生在打印机内部:由打印机的 CPU 执行 PostScript 程序完成推理,再把结果交给打印机输出。
换句话说,打印机里那套最平常不过的页面描述语言,这次被改造成了 AI 推理引擎的载体。
内存不够,就轮流用
打印机内存极小,装不下完整的模型。实验采用的做法是动态层加载:不一次性把整个模型载入内存,而是把模型的各层轮流调入、调出。这样一来,任意时刻内存里只需要保留当前正在计算的那一层,峰值占用被压到了约 14.1MB。
模型推理一共涉及 18 个 Transformer 网络层。为了让这个极限环境跑得动,模型经过了量化处理,权重精度被压低,推理引擎也被精简到极小。
速度有多慢:每词元约 60 秒
极限压缩的代价是速度。实验给出的核心数字是:整体处理速度约为每个词元 60 秒——注意是”每词元 60 秒”,而不是”每秒 60 个词元”。
具体拆分来看,在预填充阶段,处理输入提示”Read the fine”耗时约 184 秒;进入解码阶段后,生成单个词元耗时约 0.1 秒,两者合计约 184.1 秒。最终,这台打印机在纸上印出了一行短句。
| 项目 | 实验数据 |
|---|---|
| 模型 | Gemma 3 270M(2.7 亿参数) |
| 设备 | 理光办公激光打印机 |
| 峰值内存占用 | 约 14.1MB |
| Transformer 层数 | 18 层 |
| 整体速度 | 约每词元 60 秒 |
| 预填充耗时 | 约 184 秒(提示”Read the fine”) |
| 单步解码耗时 | 约 0.1 秒 |
| 是否改动硬件 | 未改固件、未加计算板 |
一次硬件极限测试,而非实用方案
需要说清楚的是,这次实验的意义在于探索边界,而不是打造一款可用产品。圣塞维耶罗本人的表述相当克制:这更像是一次把硬件推到极限的测试,把模型层数、内存峰值和单步耗时都压到了可量化的边界上,距离真正能干活还相当遥远。
它真正证明的是,即便是打印机这样内存极度受限、人们通常认为算力不足的设备,也能通过编译与量化的巧思勉强跑起一个语言模型。从这个角度看,它更像一次面向工程好奇心的探索:把推理引擎塞进最不可能的地方,看看极限到底在哪里。
常见问题
这次实验用的是哪款模型和设备?
模型是谷歌的 Gemma 3 270M,参数量 2.7 亿;设备是一台理光办公激光打印机,推理全程由打印机内部 CPU 完成。
14.1MB 内存为什么够用?
因为采用了动态层加载,模型各层轮流进出内存,峰值占用因此被压到约 14.1MB,而不是一次性装入整个模型。
打印机跑大模型的速度如何?
整体约每词元 60 秒。预填充阶段处理提示约 184 秒,解码单个词元约 0.1 秒,输出一段短句往往需要等待数分钟。
这个方案现在能实用吗?
暂时不能。实验者明确表示这是一次极限测试,并未修改固件或加装硬件,距离日常可用还很远。
信息来源
IT之家 2026 年 11 月 20 日报道;凤凰网科技、新浪财经、腾讯新闻、网易科技同题报道;奥马尔·圣塞维耶罗于 2026 年 11 月 17 日在 X 平台发布的实验内容。