结论:英特尔于 2026 年 11 月 12 日在首尔 AI 峰会宣布联合 23 家韩国企业成立”K-AI 全栈联盟”,并展示下一代数据中心 GPU D270,350 瓦功耗下 FP4 算力达 26200 TFLOPS。
关键数字:23 家联盟成员 / 26200 TFLOPS FP4 / 350 瓦功耗
| 指标 | 数值 | 对比说明 |
|---|---|---|
| 联盟首批成员 | 23 家 | 覆盖服务器、AI 芯片、大模型、云服务商 |
| GPU D270 FP4 算力 | 26200 TFLOPS | 350 瓦功耗下提供 |
| 运行 Gemma 模型延迟 | 降低 30% | 对比英伟达 RTX 6000 Pro |
| AI 智能体性能 | 提升 2.2 倍 | 对比英伟达 RTX 6000 Pro |
| 金融仿真计算性能 | 最高提升 5.9 倍 | 对比英伟达 RTX 6000 Pro |
“K-AI 全栈联盟”覆盖哪些企业
首批 23 家成员覆盖韩国 AI 全产业链。服务器制造商以 KTNF 为代表;AI 芯片与 NPU 设计初创包括 FuriosaAI、DEEPX;大模型开发商有 Upstage;云计算与软件服务商涵盖 MegazoneCloud、Hancom。英特尔称,联盟目标是在韩国构建覆盖完整技术栈的主权 AI 与开放式 AI 基础设施生态。
D270 算力为何敢对标英伟达
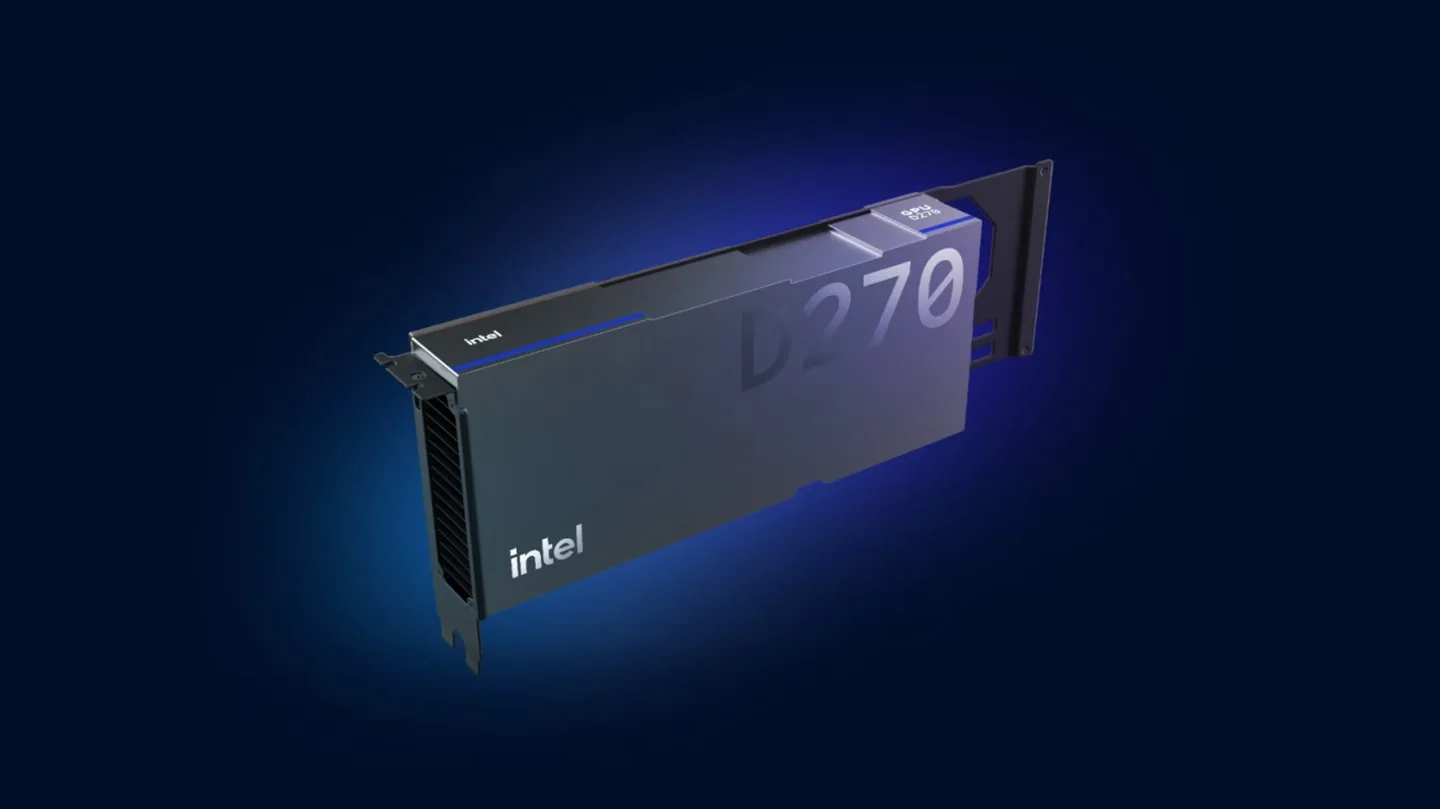
英特尔在峰会现场公开展示了下一代数据中心推理加速器 D 系列实体芯片 D270。官方数据显示,该芯片在 350 瓦功耗下提供 26200 TFLOPS 的 FP4 算力。在与英伟达 RTX 6000 Pro 的对比中,D270 运行 Gemma 模型延迟降低 30%,AI 智能体性能提升 2.2 倍,金融仿真计算性能最高提升 5.9 倍。
英特尔为何押注韩国市场
2026 年 11 月 12 日的首尔 COEX 峰会,是英特尔在亚洲推进 AI 基础设施布局的关键一站。在英伟达主导全球 AI 加速器的背景下,英特尔选择以联盟形式绑定本地企业,用开放生态对冲单一供应商格局。这意味着韩国市场的 AI 基建竞争已进入”主权化”阶段。
D270 面向数据中心推理场景,适合对算力密度与能效比敏感、且希望降低对英伟达依赖的云服务商与行业客户。韩国本地服务器与云厂商将最先受益。对行业而言,英特尔把”主权 AI”作为卖点,意味着 AI 算力市场正从单极走向多供应商竞争。值得注意的是,D270 的实际量产节奏与软件生态成熟度,仍是决定其能否落地的前提。
常见问题
“K-AI 全栈联盟”包含哪些类型的企业?
覆盖服务器制造、AI 芯片与 NPU 设计、大模型开发、云计算与软件服务四类,首批 23 家,包括 KTNF、FuriosaAI、DEEPX、Upstage、MegazoneCloud、Hancom 等。
D270 相比英伟达 RTX 6000 Pro 强在哪?
官方对比显示,D270 运行 Gemma 模型延迟降低 30%,AI 智能体性能提升 2.2 倍,金融仿真计算性能最高提升 5.9 倍,功耗为 350 瓦。
信息来源:IT之家援引韩媒 The Elec,英特尔 2026 人工智能峰会(2026 年 11 月 12 日,首尔 COEX)现场信息。