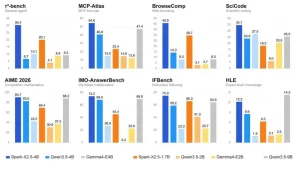
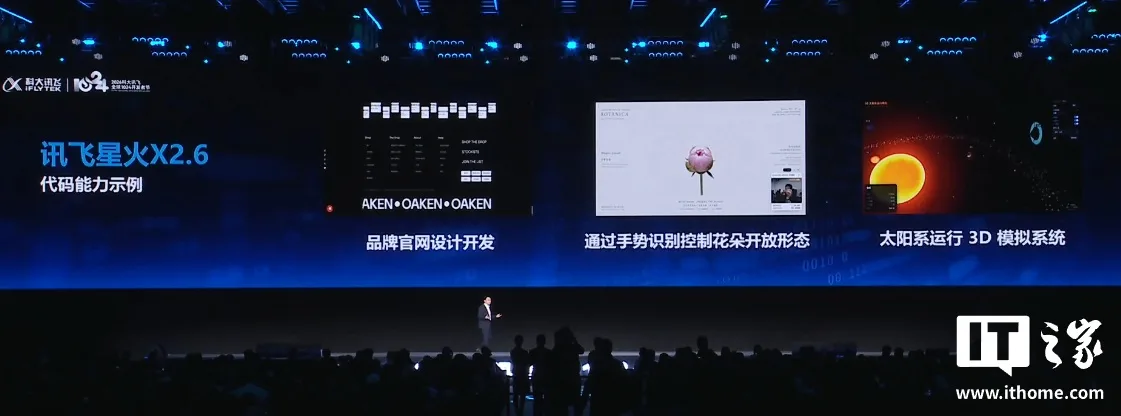
10 月 22 日,2026 科大讯飞全球 1024 开发者节在北京主会场开幕,主论坛上新一代大模型「讯飞星火 X2.6」正式发布。这代模型最关键的标签是「全国产算力训练」:据科大讯飞披露,星火 X2.6 基于国产算力完成训练,采用 293B-A30B 参数的 MoE(混合专家)架构,上下文长度拓展至 1M,也就是一次可处理约 100 万 token(词元),代码与智能体能力达到业界一流水平,并覆盖全球 200 余种语言。
为什么「全国产算力」被反复强调
科大讯飞董事长刘庆峰在发布会上表示,星火是目前唯一一家基于全国产算力训练的主流大模型,其他模型大多在英伟达显卡上完成训练,且讯飞所用模型的尺寸是最小的。他认为,这套路线已经率先突破国产芯片在长程任务上的训练效率瓶颈——通过适配国产平台的长程任务动态并行训练技术,解决了因国产芯片显存带宽限制而导致的混合训练效率低下问题。
在国产算力集群的推理效率层面,科大讯飞实现了两项创新:一是基于国产异构算力的分布式推理技术,化解国产芯片显存带宽限制带来的「训不快」难题;二是提出基于国产设备的开发技术,让许多中间结果无需重复计算,可直接复用原有成果。
1M 上下文意味着什么
100 万 token 的上下文,相当于一口气读完整套企业合同库、病历库或代码仓库。这对法律、办公、医疗、科研等需要「读完整本资料再回答」的场景,是实打实的能力跃迁,也是支撑 AI 智能体执行多步长程任务的基础。
与 X2.6 同步亮相的,还有一套全国产「云 + 端」协同方案。其思路是按任务性质分配算力:约 60% 的简单、敏感任务在端侧本地完成,30% 走端云一键协同,10% 交由云端护航。对病历、合同、企业内部资料这类数据,留在本地处理可规避出本机的风险;对手机语音指令等高频轻量请求,端侧运行几乎零成本。
端侧开源模型与定价
同场发布的星火 X2.6-4B 是一款 4B 级别的端侧通用语言模型(Dense 架构),面向手机、电脑、汽车与物联网设备,在代码、智能体、长文本和多语言能力上较上一代 X2.5-4B 明显提升,并新增三档推理模式;据称其自研推理框架的效率优于 ollama。自 9 月 1 日 X2.5-4B 开源以来,该系列下载量已进入全球端侧模型前四。
定价方面,星火 X2.6 限时输入 0.9 元 / 百万 token,输入缓存命中 0.08 元 / 百万 token,输出 3.6 元 / 百万 token;X2.6-4B 端侧模型推理定价限时免费。
同场的其他国产 AI 进展
本届开发者节还集中展示了多条产品线:全国产语音基座大模型 Spark-Audio、由讯飞联合华为基于昇腾生态打造的全国首个国产万卡算力底座「飞星平台」、支持 122 种语言互译并具备唇动识别降噪的讯飞 AI 眼镜,以及面向企业的星帆 WinWork 数字员工平台。
据科大讯飞 2026 年半年报披露,讯飞开放平台开发者团队总数已超 1155 万,其中大模型开发者达 323 万;2026 年 6 月单月 token 调用量已达到 2025 年全年总量的 2 倍。从数据看,围绕星火大模型的生态已经从「做演示」进入到「真实跑业务」的阶段。