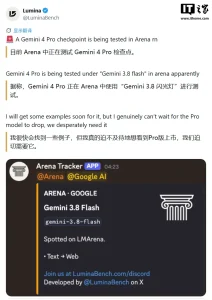
谷歌于当地时间 9 月 30 日推出旗舰人工智能模型 Gemini 4 Argon。据彭博社报道,该模型首先向一小批经过筛选的网络安全合作伙伴开放,在完成更多测试后,将优先面向付费订阅用户扩大开放范围。
谷歌称,Gemini 4 Argon 在多项基准测试中取得靠前得分,其中一项安全能力测试的成绩超越了 OpenAI 的 Astra 模型。不过彭博社同时报道,部分参与项目的知情人士表示,当谷歌员工实际用该模型开展工作时,其在代码编写等核心任务上的表现不如基准测试亮眼,尤其不擅长前端设计类工作。
基准成绩与定价
据公开资料,Gemini 4 Argon 在 DeepSWE v1.1 代码基准上取得 77.9% 的成绩,在 CWE-bench v1 漏洞修复测试上为 68%,在 AutomationBench 端到端业务任务上为 51.3%。该模型单次输出最高可达 100 万 token(约 75 万单词),定位软件工程、金融、法律与网络安全等时长较长、复杂度高的任务。
定价方面,入门阶段输入 token 为每百万 2 美元、输出 token 每百万 10 美元,后续将上调至每百万 4 美元与 20 美元。
内部看法出现分歧
谷歌否认”实战表现不佳”的说法,并将彭博社的问询引向谷歌 DeepMind 负责人科拉伊·卡武库奥卢(Koray Kavukcuoglu)此前的公开表态——他对团队性能”抱有十足信心”。一名熟悉研发的谷歌员工则称,公司内部已”形成广泛共识”,认为 Gemini 4 处于行业前沿。
也有员工认为,Anthropic 的 Fable 与 OpenAI 的 Astra 迭代速度已超过 Gemini;另有员工认为新版本已追上领先实验室。业内专家将这种现象称为”基准跑分内卷(Benchmaxxing)”:过度追求测试分数,而非真正把任务做好。
追赶之路并不轻松
Gemini 3 于去年 11 月发布,被视为谷歌追赶 OpenAI 与 Anthropic 的转折点。谷歌曾在今年 5 月 I/O 大会公布 Gemini 3.5 Pro,并承诺次月发布,但据知情人士称该项目后续被搁置。彭博行业研究分析师估算,训练这一级别的大模型单次运行开销最高可达 4 亿美元。
对谷歌而言,Gemini 4 是其几乎全部产品(搜索、地图、邮箱、Chrome)的底层支撑,每一款用户规模都超过十亿。若拿不出顶尖新一代模型,OpenAI 与 Anthropic 打造的编程智能体等产品,就将获得更多说服用户迁移的机会。