一台2013年发售的老旧游戏主机,如今能在完全断网的情况下跑起一个90亿参数的大语言模型。这不是科幻设定,而是开源项目 Garlic LLM 交出的实测成绩——在越狱版的索尼 PlayStation 4 上,文本生成速度最高可达每秒43个词元(Token),部分场景甚至不输主流个人电脑。
这个由开发者 Leonardo Alegría 打造的项目,把游戏主机变成了一台可离线聊天、语音对话、编写代码的”本地AI终端”,也为老旧硬件的再利用提供了想象空间。
绕开驱动:直接和GPU”对话”
Garlic LLM 最特别的地方在于对硬件底层的处理。常见的本地大模型方案大多依赖 Vulkan 或 OpenCL 这类图形框架,先由驱动层中转,再调用显卡算力。该项目却绕开 PS4 原本面向游戏图形处理的驱动,直接向这台基于 AMD GCN 架构 GPU 的主机下达底层指令。
开发者没有使用现成的 llama.cpp 或 Vulkan 移植方案,而是用 OpenCL C 手写计算算子,并手动构建 PM4 指令缓冲,直接把命令发给 GPU。项目名”Garlic(大蒜)”取自 PS4 的 GPU 访问系统内存所用的内存路径名。CPU 端用纯 C 语言处理分词、界面、文本渲染与音频,整套构建基于开源的 OpenOrbis 工具链。这种”越级”通信降低了指令延迟,代价是 PS4 未提供通用 GPU 计算接口,所有底层工具都得自己写。
90亿参数如何塞进8GB内存
PS4 只有8GB统一内存,由 CPU 和 GPU 共享,而90亿参数的模型仅权重就需至少9GB。解法是量化压缩:采用阿里巴巴的通义千问 Qwen3.5-9B 作为基座,把大部分权重压到4位、每层最大的两个矩阵用3位,平均约3.5位,连同加速数据整体压到约4.5 GiB。注意力缓存也做了4位量化,从而支持约1.6万词元的上下文窗口。
| 组件 / 指标 | 参数 |
|---|---|
| 模型基座 | 通义千问 Qwen3.5-9B(90亿参数) |
| 量化方式 | 4位为主、部分3位,平均约3.5位 |
| 模型+加速数据 | 约4.5 GiB |
| 上下文窗口 | 约1.6万词元 |
| 语音组件 | Chatterbox 合成 + Parakeet 识别 |
| 安装包体积 | 约5.66GB |
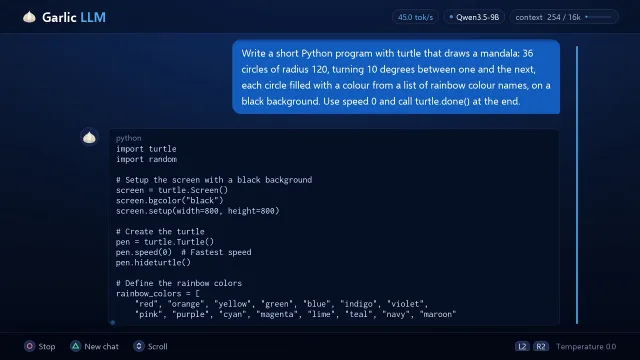
在速度上,项目借助 Qwen3.5-9B 自带的多词元预测(MTP)机制做推测解码:先起草最多两个词元,再由完整模型验证。实测普通文本生成约每秒31至39个词元,代码生成最高每秒43个词元;默认采样温度0.7,与阿里官方对通用场景的推荐一致。
不只能打字:语音、推理、跑代码
除文字聊天外,Garlic LLM 还集成完整语音链路:用英伟达的 Parakeet TDT 0.6B v3 做语音识别,支持25种欧洲语言;用 Chatterbox 做语音合成,支持7种语言输出。玩家按住手柄按键即可录音,全程离线对话,开启语音后速度约每秒22个词元。应用还提供”思考模式”,让模型先推理再回答,并能在主机上执行 AI 生成的 Python 代码。
需要说明的是,每秒43个词元是代码生成场景的峰值,并非日常平均值。不同模型、量化精度和软件之间的词元速度不能直接横向比较,”比电脑还快”更多是一种宣传式对比,而非严格基准测试。
想上手需要什么
运行 Garlic LLM 需要一台运行 GoldHEN 自制系统的越狱版 PS4、约6GB可用空间,以及从 Hugging Face 免费下载的安装包,通过软件包安装器安装。开发者已在固件11.52的 PS4 Slim 上完成测试,源码以 GPLv3 协议在 GitHub 开放。这是面向技术爱好者的成果展示,而非开箱即用的产品,但它证明:经过极致的软硬协同优化,十多年前的老主机也能跑通一场完整的离线智能对话。
常见问题
Garlic LLM 可以让普通 PS4 直接运行吗?
不可以。它需要越狱并运行 GoldHEN 自制系统,属于面向开发者的实验性项目,且仅在特定机型上验证过。
为什么说它”完全离线”?
模型、语音识别与合成组件全部打包在本地安装包内,运行时不需要联网,聊天和语音对话都在主机本地完成。
每秒43词元是常态速度吗?
不是。这是代码生成场景的峰值,常规文本生成约每秒31至39个词元,开启语音后约22个词元。
信息来源
本文数据来源于 Gigazine、IT之家、腾讯新闻及开发者在 Hugging Face、GitHub 公开的项目资料,图片来源:IT之家。