华为麒麟官方公众号于 11 月 10 日发布长文,系统介绍了首款采用「逻辑折叠」技术的 τ 芯片——麒麟 9050 系列。这套方案围绕计算、人工智能、图形、影像、通信、音视频、显示与安全八大核心单元做了协同升级,把芯片设计的重心从单纯缩减晶体管尺寸,转向压缩信号在芯片内部的传输时间。
逻辑折叠到底改了什么
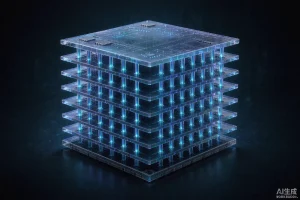
传统做法靠更先进的光刻工艺把晶体管做得更小,从而塞进更多计算单元。华为提出的「韬定律」(τ-scaling)另辟路径:用「时间缩微」替代「几何缩微」。具体做法是在设计阶段就把多颗裸片当作一颗完整芯片来规划,把原本平铺的逻辑电路折成上下两层,两层之间用混合键合直接相连,靠垂直互连传输信号,让数据不必再横向绕路。
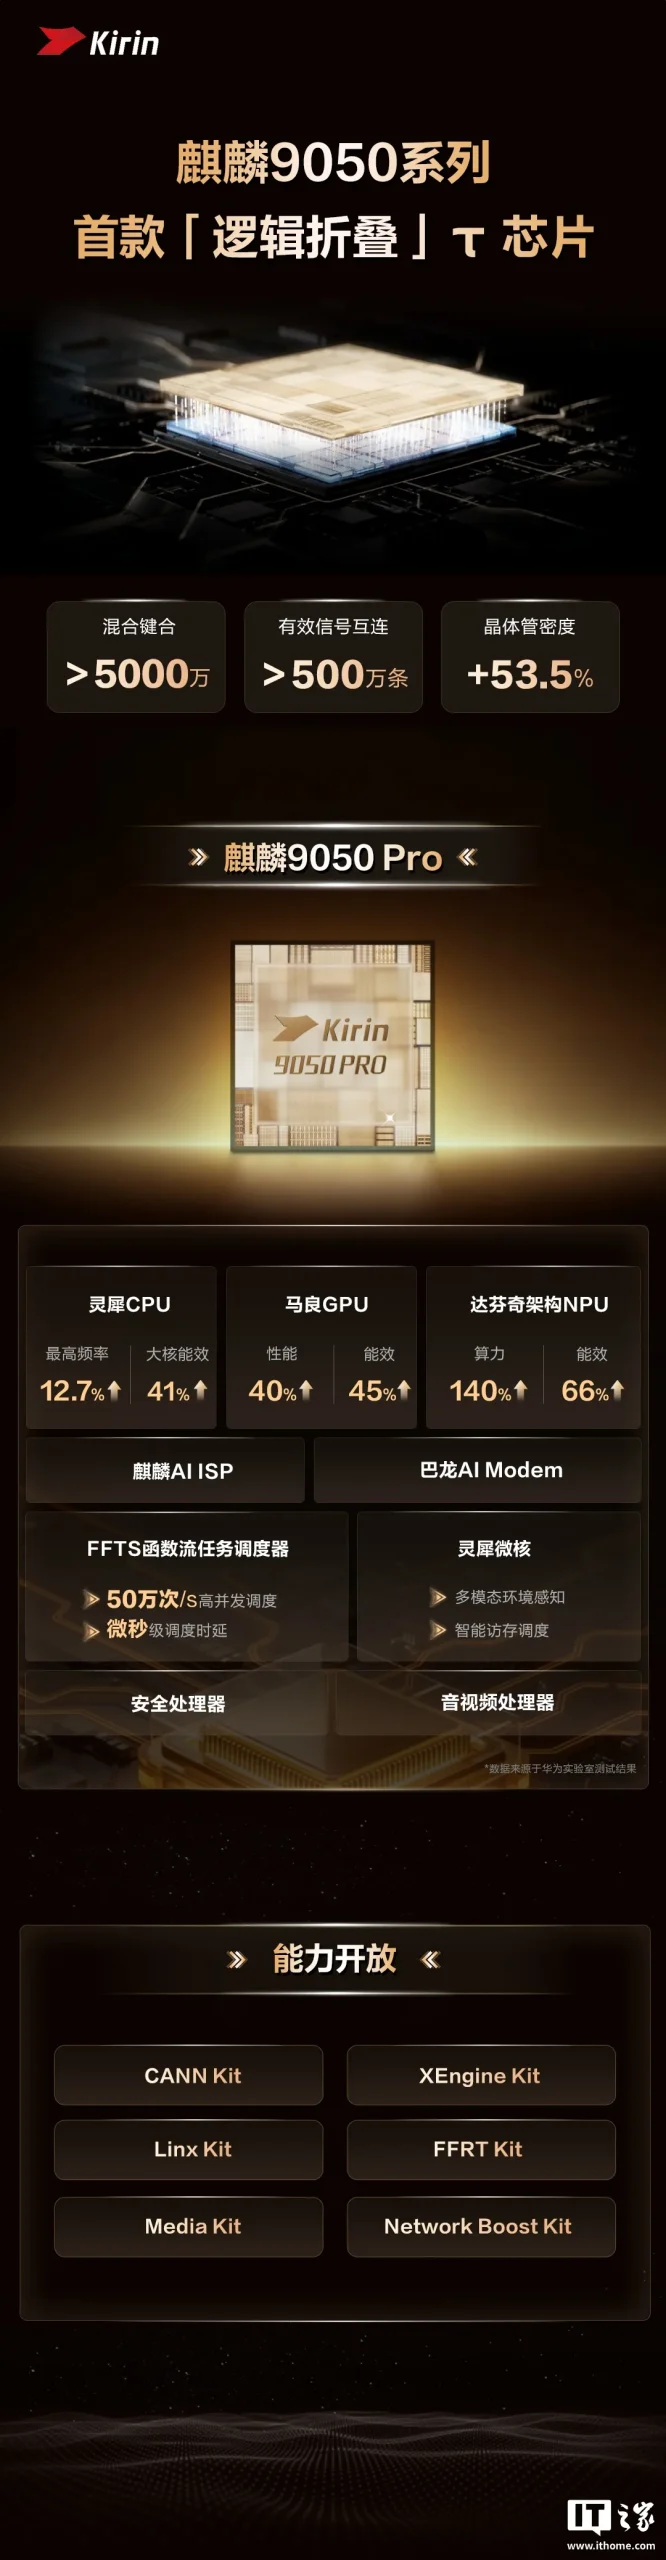
华为公布的数据显示,麒麟 9050 系列的混合键合点超过 5000 万个,有效信号互连超过 500 万条。在关键路径上,信号延迟下降了约 30%。晶体管密度则提升了 53.5%,其中麒麟 9050 Pro 每平方毫米可容纳约 2.38 亿个晶体管。
性能与能效的具体数字
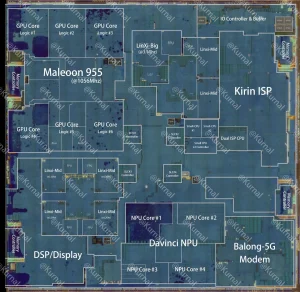
支撑这套架构的,是麒麟 9050 Pro 的几大计算单元。灵犀 CPU 采用 9 核 16 线程设计,包含一颗 3.1GHz 超大核、两颗 2.7GHz 性能大核、四颗 2.2GHz 能效大核与两颗 1.75GHz 小核,并支持超线程;最高频率提升 12.7%,大核能效提升 41%。马良 GPU 采用 6 核微架构,渲染性能提升 40%,能效提升 45%。达芬奇架构 NPU 的算力提升 140%、能效提升 66%,可在端侧运行约 300 亿参数的混合专家(MoE)大模型。
影像与调度方面,麒麟 AI ISP 配合 FFTS 函数流任务调度器,可实现每秒 50 万次的高并发调度,调度时延达到微秒级。通信部分搭载巴龙 AI Modem,并内置独立安全处理器。整体方案还包含灵犀微核、音视频处理器等组件,主打全场景低功耗与芯片级隐私安全。
量产落地与生态配套
华为方面称,麒麟 9050 系列已经实现量产,下一代麒麟 2027 芯片已进入测试阶段,测试结果符合预期。在 10 月 13 日于上海练秋湖举行的 2026 麒麟媒体沟通会上,华为半导体业务无线终端芯片产品管理部部长徐松余首次公开了麒麟 9050 Pro 的详细架构图。
工艺层面,当前麒麟 9050 Pro 的混合键合间距为 1.5 微米,华为计划在 2027 年进一步缩小到 1 微米。间距越窄,单位面积内可布置的连接通路越多,更多电路就有机会选择跨层直连,从而进一步缩短信号等待时间。
为了让开发者释放硬件能力,华为同步开放了 CANN Kit、XEngine Kit、FFRT Kit、Media Kit、Network Boost Kit 等多类开发工具套件,覆盖人工智能计算、图形渲染、媒体处理与网络增强等维度。
从「参数领先」到「系统级创新」
从这一代公开的数据看,华为把更多力气花在了能效而非峰值频率上:CPU 最高频率只提升 12.7%,但大核能效提升 41%;GPU 性能提升 40%、能效提升 45%;NPU 算力提升 140%、能效提升 66%。性能涨幅普遍小于能效涨幅,意味着同样的电量可以完成更多计算,日常使用中的发热与续航表现可能比跑分变化更明显。
在芯片工艺逼近物理极限、单纯靠缩小晶体管尺寸提升性能的空间逐渐收窄的背景下,逻辑折叠代表了华为在系统级创新上的一次尝试。其价值不只是单点参数,而是通过重新组织电路的连接方式,为端侧人工智能体验打开新的空间。
(文中数据均来源于华为官方公布的实验室测试结果。)