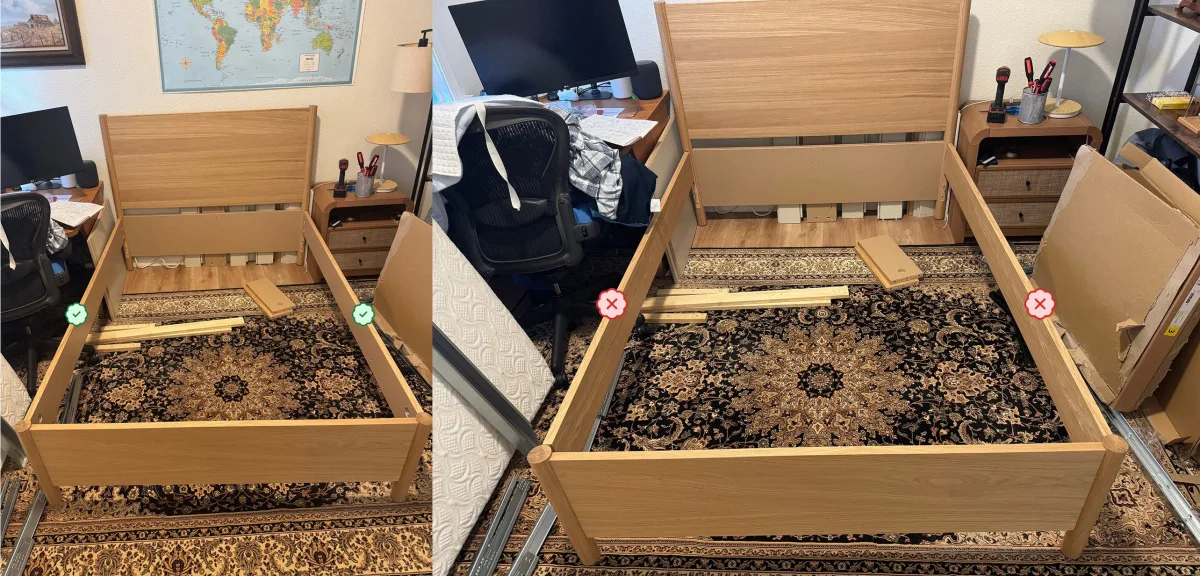
装家具装到一半才发现板子装反了——这类让人抓狂的体验,未来或许会有 AI 来兜底。人工智能评测机构 Epoch AI 于当地时间 9 月 23 日发布了一项名为「家具组装基准测试」的新评测,专门考察多模态模型能否通过照片对照说明书,发现宜家家具在组装过程中出现的错误。
测试怎么考
该基准测试准备了三款宜家家具,研究人员故意进行错误组装,并在不同阶段拍摄共 60 张过程照片。参测模型会同时拿到组装照片、官方 PDF 说明书、图片放大工具以及 Python 解释器,需要判断是否存在错误,并定位具体出错步骤、说明问题所在。评分采用多阶段验证:只要模型能正确找到错误步骤并大致描述问题,即可得分。
准确率一年涨近三倍
结果显示,OpenAI 最新的 GPT-6 Astra 以 80% 的准确率位居榜首。Anthropic 的 Claude Fable 5.1 和 Claude Opus 5 分别达到 70% 和 61%。作为对比,2025 年 11 月时的领先模型 Claude Opus 4.5 准确率仅为 28%——前沿模型在约 10 个月内实现了近三倍的提升。
除了准确率,GPT-6 Astra 的推理效率也明显改善。其完成单张照片分析的中位耗时约为 3 分钟,是研究中速度最快的模型,比此前领先模型快约 2 至 10 倍。不过研究人员也指出,这一速度距离真正意义上的实时组装指导仍有差距。
不同模型的「翻车」方式
研究还归纳了模型的典型错误模式:谷歌 Gemini 和阿里 Qwen 系列模型几乎总是先假定存在错误,再去找错;而早期 Anthropic 和 OpenAI 模型则相反,经常完全找不到错误。研究者认为,错误是否隐蔽、拍摄视角以及出错后继续组装的程度,比家具本身的复杂度更能影响难度。
中国模型的表现
在中国模型中,目前表现最好的开源权重模型 Kimi K3 相比国际前沿约落后 7 个月,这一差距比其在综合能力评估中约 4.4 个月的差距更大。研究指出,精细视觉推理仍是中国部分模型的相对薄弱方向,而 DeepSeek V4 Pro、GLM 5.3 等热门模型暂时未提供图像理解能力。
意义不止于家具
Epoch AI 认为,这类任务结合了图像理解、空间推理与多步骤指令匹配,能够较好地反映多模态模型处理现实问题的水平。随着相关能力提升,未来 AI 有望在汽车维修、家电检修、设备安装等需要结合图像与技术说明进行判断的场景中,提供更具针对性的实时辅助;制造质检、远程技术支持等流程也有望受益。