9月20日,哔哩哔哩(B站)宣布上线“AI无限竞技场”大模型测评榜,并同步公布首轮模型排名。与传统实验室跑分不同,这份榜单把出题权交还给每天真正使用大模型的人——平台上的创作者,用真实任务场景来检验各家模型的实际能力。
上百款模型同台,创作者自主命题
据B站介绍,“AI无限竞技场”是一个汇聚平台创作者大模型测评内容的竞技广场。榜单基于各领域创作者对上百款大模型的真实场景实测,覆盖代码生成、逻辑推理、协作办公、知识问答等多种主题。
与传统评测先划定维度和题目、再让模型依次作答的思路不同,“AI无限竞技场”不设主题或测评维度的限制。来自不同内容分区的创作者依据真实工作流、专业应用场景和趣味创意自主命题,在同题比拼中直观呈现各模型在具体任务里的表现差异。换句话说,模型面对的不是标准基准测试的固定题目,而是具体的人和具体的活儿。
榜单覆盖的对比对象既包括 DeepSeek、Kimi、豆包、通义千问、Hy、MiniMax 等中国本土模型,也包括 ChatGPT、Claude、Gemini 等海外模型,排名实时更新,并持续向全站创作者开放报名。
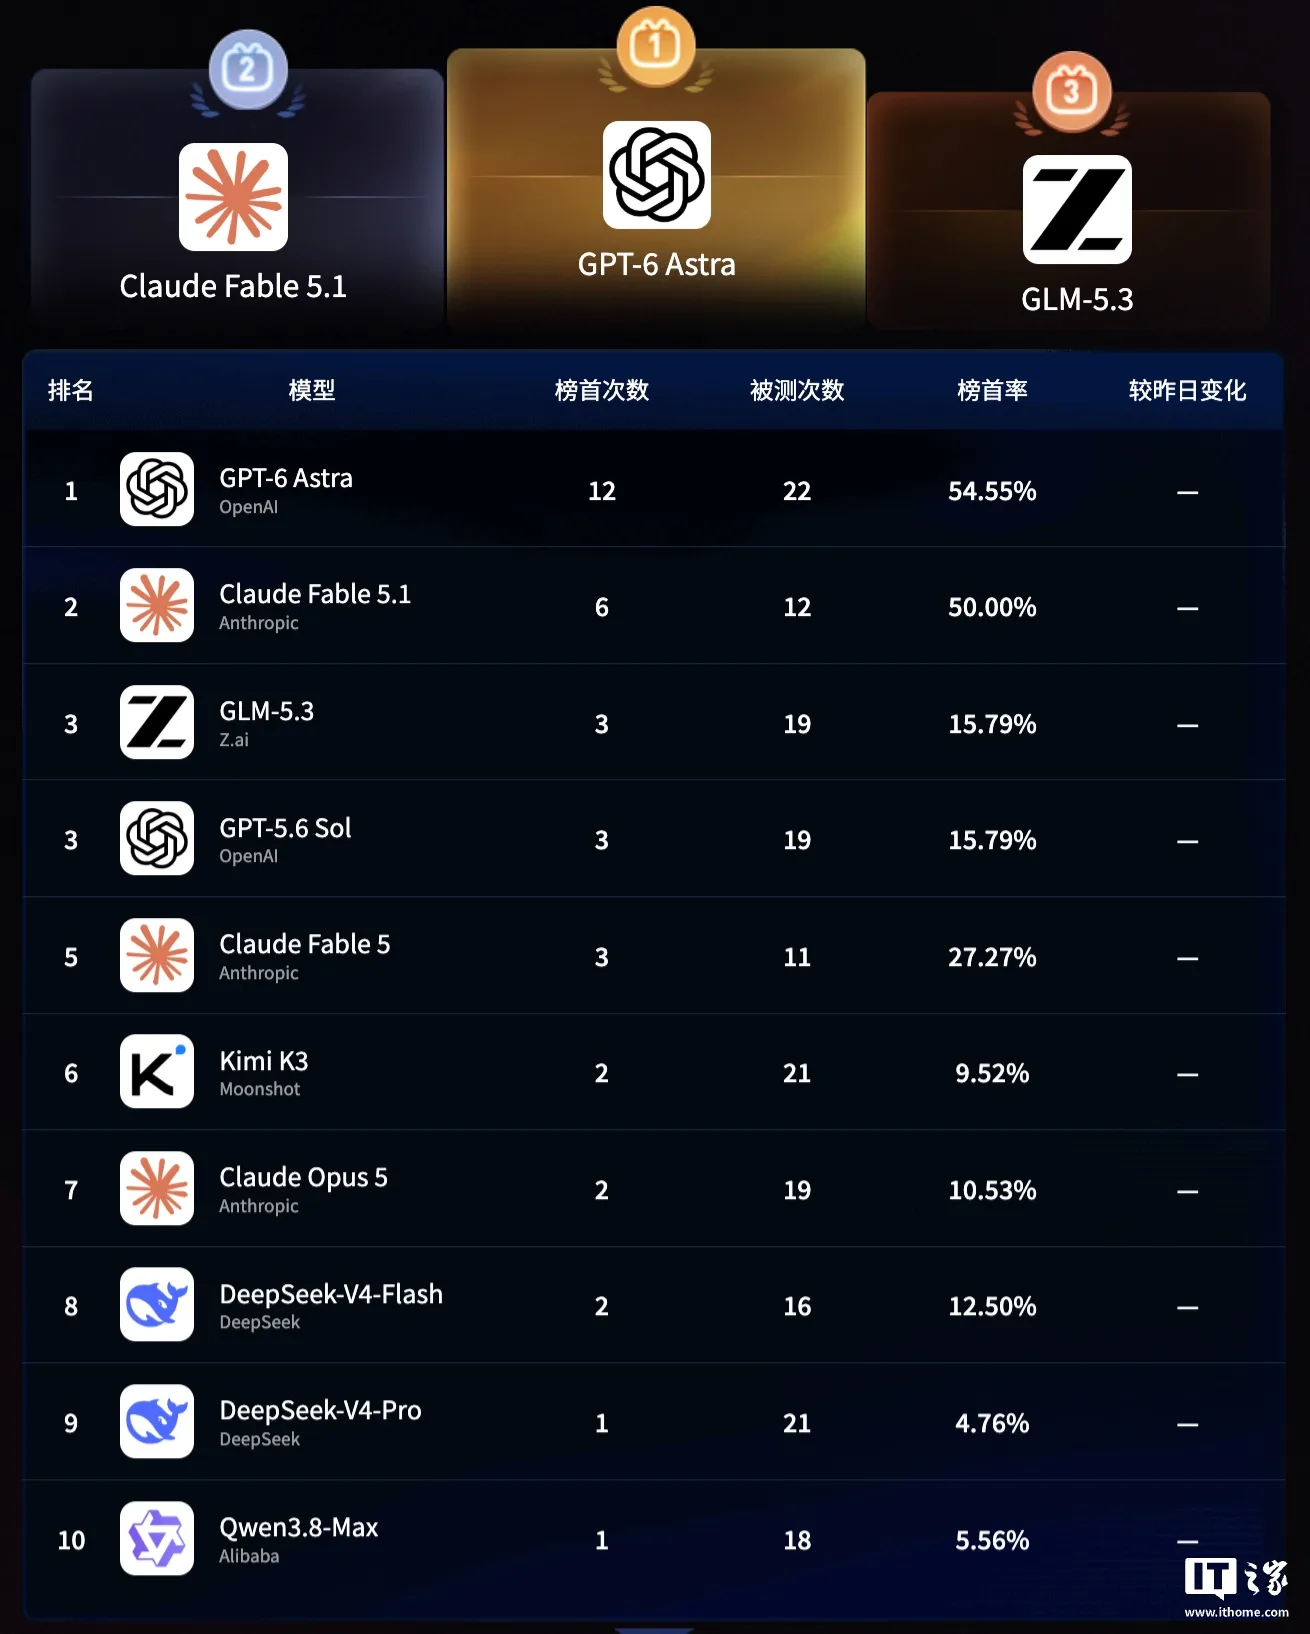
首轮榜单:GPT-6 Astra 登顶次数居首
首轮结果中,GPT-6 Astra 在参与的 10 位创作者测评里拿下第一,并在与 GLM-5.3 的对比中成为登顶次数最多的模型;排名前五的模型中,中国国产大模型占据三席。
需要指出的是,首期榜单并非定局。报名机制意味着后续测评主题与出题人将持续增加,排名也会随之变动。对普通用户而言,这类榜单的价值不在于“谁排第一”,而在于能直观看到同一款模型在写代码、做推理、协作办公这些具体场景里到底差在哪一步。
1.9亿月活背后的测评土壤
这份榜单之所以能够成立,前提是平台上已经生长出足够密集的测评内容。公开信息显示,过去一年B站人工智能知识内容的消费时长同比增长 72%,月均观看人工智能相关内容的用户超过 1.9 亿。围绕模型发布、用户讨论、实测评估、使用体验、求助反馈到共建优化的完整内容生态已经形成。
当“测评”本身成为一种常态化的内容形态,把它收拢成一张可对比、可更新的榜单,在逻辑上顺理成章。对模型厂商来说,这是一个基于真实创作场景的能力观察窗口;对用户来说,则多了一个判断模型在非标准化任务中实际可用性的参考。