阿里巴巴旗下阿里千问于 9 月 19 日正式发布同声传译大模型 Qwen3.8-LiveTranslate。该模型以 Interleave 架构重构实时同传流程,将字均延迟(LAAL)从 2.8 秒降至 2.3 秒,在准确度、流畅度与简洁度上较上一代均有提升,面向会议、直播、课堂与跨国沟通等真实场景。
从 2.8 秒到 2.3 秒
实时同声传译最大的难点不在”翻得准”,而在”翻得跟得上”。字均延迟衡量的是源语言语音与其对应译文之间的平均滞后,在长达两小时的跨国会议里,半秒之差就可能造成说话人已翻篇、译员还在补上一句的脱节。
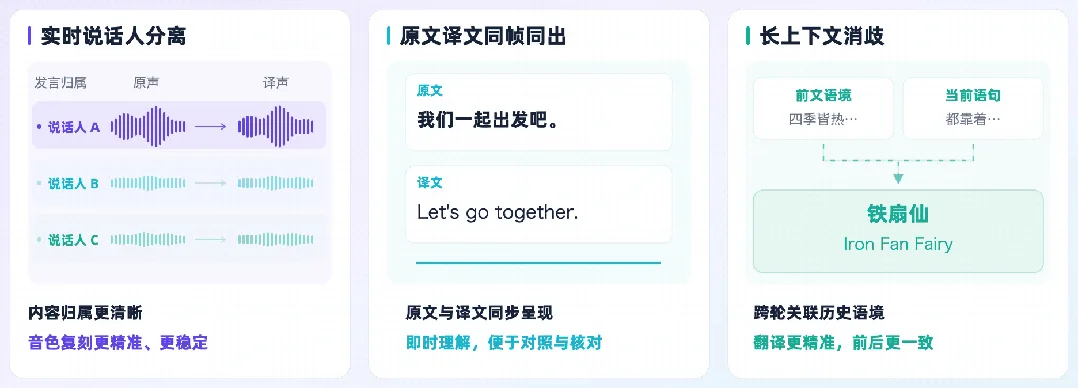
在支持 60 种语言的基础上,Qwen3.8-LiveTranslate 新增三项能力,直指同传落地时最容易被卡住的环节:实时说话人分离让每句话归属清晰、音色复刻更稳定;原文译文同帧同出实现双语同屏;长上下文消歧则联系前文语境理解当下内容,让人名与专业术语的翻译更精准。这三项能力过去往往要靠人工译员兜底,如今被写进了模型的能力清单。
Thinker 与 Talker 各管一段
技术路线上,Qwen3.8-LiveTranslate 采用基于 Hybrid MoE 的 Thinker–Talker 双模块设计,通过 Interleave 方式衔接流式理解、文本输出与语音生成。其中 Thinker 把视频、音频、原文与译文编排进同一条因果序列,按时序交替排列、端到端产出,让理解与翻译在单一序列内完成;Talker 则结合译文与源音频,将译文合成为保留原说话人音色的语音。
这种单模型内端到端的处理方式,替代了传统”语音识别 + 机器翻译 + 语音合成”逐级串联的流水线,减少了每一级衔接带来的缓冲与误差传播。语义单元预测让模型能在完整句子到达前就吐出连贯短语,动态采样控制新上下文到来时的输出时机,混合专家设计则把每个 token 只路由到模型参数的一部分,从而压低计算量。
评测全面领先主流系统
在覆盖 14 个语向的多说话人长音频评测集 Omnilingua-MSpeaker 上,Qwen3.8-LiveTranslate 在翻译忠实度、流畅度、简洁度以及说话人分离错误率(DER)四个维度上,均优于当前行业主流实时同传系统。官方还在公开 FLEURS 音频测试集上评测了 70 个语言方向的实时同传表现,结果显示其在翻译质量、字均延迟、语音识别准确率与语音合成质量四个维度上,均领先于上一代模型及当前主流实时同传系统。
用户可通过官方体验链接尝鲜,相关模型 API 也已同步开放。对于需要跨语言沟通的会议、直播与教学场景,这类将说话人分离、双语同屏与术语消歧整合进单一接口的同传模型,正在把过去由多个独立语音服务拼凑的流程压缩成一次调用。