2026 年 9 月,全球 AI 大模型进入”周抛”节奏:9 月 1 日至 3 日,Anthropic Claude Fable 5.1、Google Gemini 3.8 Flash、OpenAI GPT-6 Astra 在 72 小时内相继发布,Meta Muse Spark 1.3 同步亮相;国产侧 Qwen3.8-Max、DeepSeek V4 Pro、Kimi K3、GLM-5.3 紧随跟进。结论先说:不存在单一”最强”模型,选型必须按任务分层。
一周四旗舰,能力各有所长
>
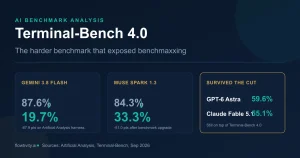
据 itproexpert 汇总的 Artificial Analysis Intelligence Index v4.3(截至 2026 年 9 月 12 日),Claude Fable 5.1 与 GPT-6 Astra 并列综合第一(53 分),前者强在知识与事实准确性,后者领先数学、计算机操作与网络安全。最快最便宜的是 Gemini 3.8 Flash,约 262 tokens/秒,定价 0.75/3.75 美元每百万 token;性价比最高的闭源旗舰是 Claude Opus 5,5/25 美元每百万 token,价格仅为双雄一半。
开源阵营里,DeepSeek V4 Pro 以 MIT 协议、SWE-bench Verified 80.6% 成为自托管代码首选;GLM-5.3 综合指数约 45,适合通用自部署。国产开源正在集体崛起:据 Hugging Face 2026 年 8 月 14 日报告,中国自研开源模型全球下载占比已达 41%,首次超过美国(数据经中文媒体转述)。
中文榜:Qwen 登顶,国产紧贴第一梯队
>
SuperCLUE 2026 年 9 月中文大模型榜单显示,阿里 Qwen3.8-Max-0902 以综合 72.62 分位居第一,DeepSeek-V4.1-Flash 71.81 分、Qwen3.8-Max 71.48 分紧随其后,三者分差不足 1 分,处于并跑状态。细分赛道则各擅胜场:智能体编程 Kimi 领先,数学推理 DeepSeek 最强,科学推理豆包最好,幻觉控制与任务规划则是 Qwen 断层领先。
怎么选最值:分层组合策略
>
对绝大多数中国用户与企业,旗舰模型的能力溢价并不划算。务实策略是把任务分层:约 80% 的简单任务用 DeepSeek V4 Flash 或 Qwen 系列,15% 中等复杂度用 DeepSeek V4 Pro,仅 5% 的核心复杂任务才上 Claude Opus 或 GPT 旗舰。按此组合,总体成本可降至纯闭源旗舰方案的十分之一以下。
需要提醒的是,推理速度与质量存在此消彼长:综合分靠前的 Qwen、Kimi 单次响应等待更长,实时交互场景应优先选性价比更高的模型。上下文窗口也不能只看宣称数字——多数宣称 128K 以上的模型在极限前已丢失约一半有效回忆,选长文本模型要看”有效区间”而非”最大窗口”。
2026 年 9 月哪个大模型最强?
>
没有全局最强。Claude Fable 5.1 与 GPT-6 Astra 综合并列第一,但 Claude 胜在代码与知识、GPT 胜在生态与数学;中文场景 Qwen3.8-Max 登顶,国产已紧贴第一梯队。
国产大模型与国际差距多大?
>
差距显著收窄。中文榜前三被国产包揽,开源侧中国自研模型全球下载占比达 41% 首超美国;但在超长周期自主工程(如 10 小时以上任务)上,国产与 Claude 仍存在约一倍的差距。
个人开发者怎么选最省钱?
>
日常用 DeepSeek V4 Flash(闲时约 0.22/0.66 美元每百万 token)或 Qwen 系列,自部署可选 GLM-5.3、DeepSeek V4 Pro(MIT 协议),几乎零授权风险;仅核心任务再调用高价闭源旗舰。
一张表看清九款旗舰定位
>
| 模型 | 厂商 | 发布 | 上下文 | 定价(美元/M) | 定位 |
|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | 2026-09-03 | 1.05M | 10 / 50 | 综合均衡标杆 |
| Claude Fable 5.1 | Anthropic | 2026-09-01 | 1M | 10 / 50 | 代码与知识王者 |
| Gemini 3.8 Flash | 2026-09-02 | 1M | 0.75 / 3.75 | 最快最便宜 | |
| Muse Spark 1.3 | Meta | 2026-09-02 | 1M | 1.25 / 4.25 | 开放权重 |
| DeepSeek V4 Pro | 深度求索 | 2026-08 | 1M | 0.14 / 0.28 | 自托管代码首选 |
| Qwen3.8-Max | 阿里巴巴 | 2026-08 | 1M | API 仅 | 中文综合第一 |
| Kimi K3 | 月之暗面 | 2026-07 | 1M | 0.60 / 15 | 智能体编程领先 |
| GLM-5.3 | 智谱AI | 2026-08 | 1M | 低价/开源 | 通用自部署 |
| Hy4 preview | 腾讯 | 2026-08-28 | 1.05M | 0.83 / 2.50 | Apache 2.0 开源 |
结语
>
大模型”周抛”时代,比拼的不再是单一榜单排名,而是谁能把对的模型放在对的任务上。对国内开发者与企业,国产开源的崛起意味着更低的门槛与更自主的数据;分层选型,才是 2026 年最务实的答案。
本文基于 SuperCLUE 2026 年 9 月中文大模型榜单、Artificial Analysis(经 itproexpert 汇总)及 Hugging Face 报告等公开数据整理分析。