结论:美国初创公司 Architect Labs 于 2026 年 11 月 22 日公布由 AI 从零设计的通用 CPU「Frostbite」,模拟测试中每瓦性能达对照核心的 4.59 倍,但芯片尚未流片,性能仍停留在仿真阶段。
关键数字:4.59 倍每瓦性能 / 8.77 倍每面积性能 / 7 纳米模拟工艺
| 测试项目 | 每瓦性能提升(对比对照核心) |
|---|---|
| 全部 25 项(几何平均) | 4.59 倍 |
| 用于设计调优的 10 项 | 6.02 倍 |
| 最终评估才引入的 15 项 | 3.83 倍 |
| 表现最好:conv2d(未调优) | 23.12 倍 |
| 表现最差:递归斐波那契(未调优) | 1.15 倍 |
4.59 倍从何而来:交互网与「免费多线程」
传统 CPU 在运行时靠硬件判断指令依赖,多核还需多级缓存与一致性协议,占用面积和功耗。
Architect Labs 的替代方案叫「免费多线程」:让程序自身暴露可并行的工作,不再依赖线程、锁和乱序执行硬件。
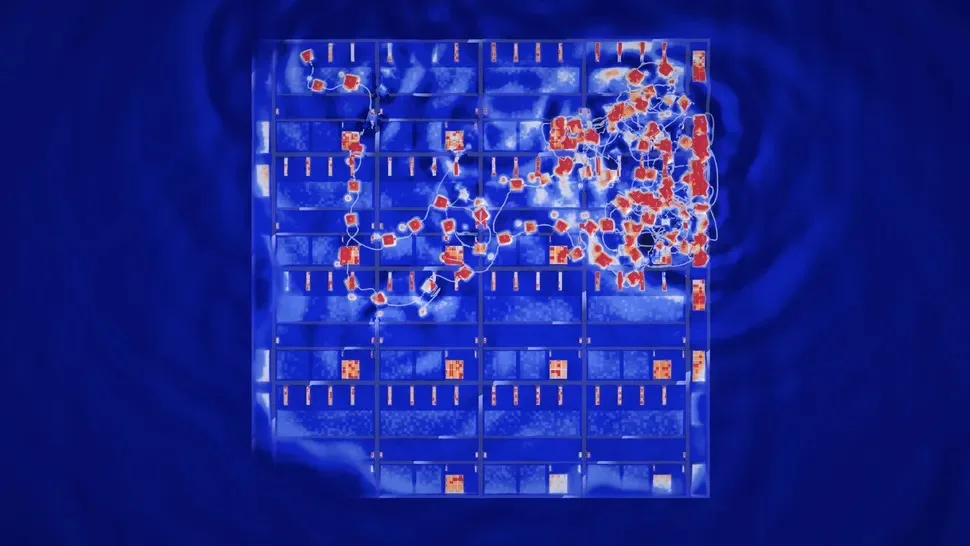
Frostbite 把程序编译成「交互网」——一种 1990 年提出的计算模型。程序是一张节点图,计算靠改写相连节点对完成;节点对互不重叠,可任意顺序甚至同时执行,结果一致。
每个值只被使用一次,数据得以留在每个计算单元的小容量本地内存里,而不必放进大型共享缓存。
还没流片:4.59 倍仍是模拟数据
这组数字来自基于 7 纳米工艺的模拟设计,Frostbite 尚未真正流片,没有实体芯片可供验证。
对照对象是一颗尺寸相近、已完成硅验证的双发射顺序执行核心;出于法律原因,公司暂不公开其型号。
测试用的是 4 个计算单元加 4 个三级缓存节点组成的集群,完整设计则包含 16 个单元。早期综合阶段频率一度达 800 兆赫,最终布局降至 500 兆赫。
值得注意的是,去掉参与调优的 10 项后,剩下 15 项的领先幅度收窄到 3.83 倍——这部分更接近设计本身的真实水平。
AI 如何设计芯片:从 141 页文档到形式化验证
参与设计的 AI 系统起点是「零架构先验」,不预设任何处理器架构理念,但团队事先选定了要优化的工作负载。
多个智能体阅读论文和评测、建立 Python 模型,最初生成一份 141 页设计文档。第一版寄存器传输级设计完成后,这份文档即被删除,因为其中许多估算与物理实现相差甚远。
此后 AI 改用自研硬件描述语言 ASL 编写规格,并可转换为 Lean 证明系统接受机器验证。配套软件模型 Arcmodel 的运行速度约为寄存器传输级仿真的 200 倍。
模型最初的功耗估算偏差接近 250%,经自动化迭代后收敛到 5% 以内。智能体共尝试 58 项优化方案,最终保留 37 项,还自发出现了人类未规定的「工作窃取」行为。
这对芯片设计意味着什么
Frostbite 把「AI 设计芯片」从概念推进到完整布局,但所有性能结论都建立在仿真之上。这意味着它目前更适合作为架构探索的样本,而非可采购的产品。
值得注意的是,能耗结构也出现变化:指令获取、解码和发射环节占比从 27% 降至 6%,片上网络与调度器却新增 26% 开销。架构收益与代价同时存在。
常见问题
Frostbite 现在能替代现有 CPU 吗?
不能。芯片尚未流片,数据来自 7 纳米模拟设计,没有实体产品可供采购或实测。
4.59 倍能效是实测结果吗?
不是实测。它是模拟设计中 25 项工作负载的每瓦性能几何平均值,对照核心型号也未公开。
普通用户何时能用上?
官方未公布 Frostbite 的流片与上市时间。公司此前公布的推理加速器 Redwood 目前也只在现场可编程门阵列上运行。
信息来源:Architect Labs 研究博客,以及 Tom’s Hardware、IT之家 2026 年 11 月 22 日报道。