结论:地平线机器人实验室在 2026 年 11 月 18 日发布视频几何基础模型 LoFT,用 297 万条训练序列让机器从普通 RGB 视频恢复三维结构,多项深度估计指标达到当前最优水平。
关键数字:297 万条训练序列 / 9.62 亿帧图像 / 12 个数据集
| 项目 | LoFT 数据 | 说明 |
|---|---|---|
| 有效训练序列 | 约 297 万条 | 覆盖仿真与真实、动态与静态场景 |
| 图像记录 | 9.62 亿帧 | 统一三维重建数据处理与训练平台 |
| SpatialBench 覆盖 | 12 个数据集、98 个连续视频场景 | 对比 VGGT-Ω、DA3-Giant |
| 其他评测体系 | ClassicBench 7 个基准、VRBench 多场景 | 涵盖机器人、自动驾驶及通用视频 |
双循环架构如何看懂连续视频
LoFT 全称 Looped Foundation Transformer for Video Geometry,是原生面向连续视频建模的基础模型。它能从 RGB 视频中联合预测相机位姿、内参与逐帧深度,进而恢复场景三维结构,为机器人空间感知、环境理解与具身学习提供几何基础。
模型核心是双循环 Transformer 架构。第一循环通过局部与全局时序注意力聚合跨帧信息,逐步扩大时间感受范围;第二循环显式更新相机位姿与内参,并把相机状态反馈至下一轮特征计算,两路特征结合后预测逐帧深度及其置信度。
官方架构图显示,双循环中的 LB1 负责通用几何特征提取,LB2 实现由粗到细的几何与姿态估计。这套设计把跨帧信息聚合与相机状态迭代放进同一流程,用于挖掘视频中的时序关联与多视角几何信息。
三套评测体系对标主流模型
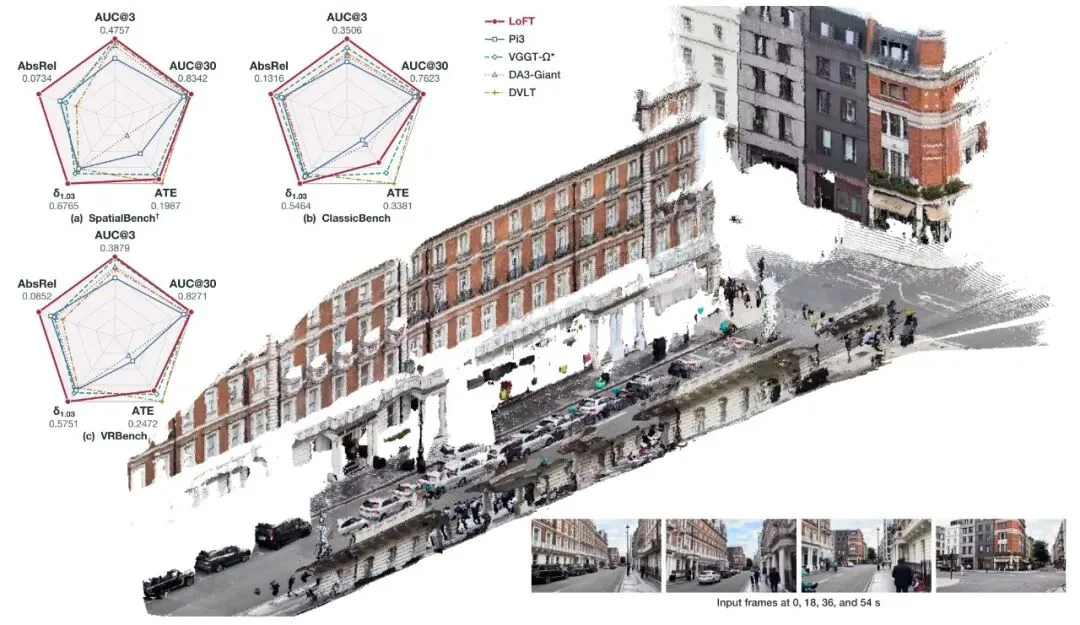
评测环节,研究团队把 LoFT 与 VGGT-Ω、DA3-Giant 等代表性模型放在 SpatialBench、ClassicBench 和 VRBench 三套体系中比较。其中 SpatialBench 覆盖 12 个数据集、98 个连续视频场景,ClassicBench 整合 7 个经典视频重建基准,VRBench 涵盖机器人、自动驾驶及通用视频场景。
据官方公布的信息,LoFT 在多项深度估计指标上达到当前最优水平。应用侧,官方给出的示例包括高频动态场景下的精准空间感知、文字级精细几何重建、驾驶场景中对动态车辆的鲁棒重建,以及复杂生活场景的高精度重建。
几何感知为何是具身智能的底座
对机器人与自动驾驶开发者而言,LoFT 的价值在于把连续视频直接转化为可用的三维结构。这意味着机器可以仅凭摄像头视频建立对物理世界的空间认知,为避障、操作与环境理解提供底层几何支持,而不必依赖额外的深度传感器。
值得注意的是,官方在项目主页之外尚未同步开放模型权重或代码,实际可用性仍待后续验证;文中所引用的多项指标达到最优,均来自地平线官方公布的信息,缺少第三方独立复现结果。
常见问题
LoFT 主要解决什么问题?
让机器从普通 RGB 视频中恢复三维结构,同时输出相机位姿、内参与逐帧深度,服务机器人空间感知、环境理解与具身学习。
和单帧处理方案有什么不同?
LoFT 原生面向连续视频建模,用双循环架构挖掘时序关联与多视角几何信息,而不是把视频拆成单帧再后处理拼接,动态场景下的几何一致性更强。
模型权重已经开放下载了吗?
官方已上线项目主页,但截至 2026 年 11 月 18 日发布时尚未同步开放模型权重或代码。
信息来源:地平线机器人实验室 LoFT 模型发布说明(2026-11-18 发布);IT之家、腾讯新闻 2026-11-19 报道。