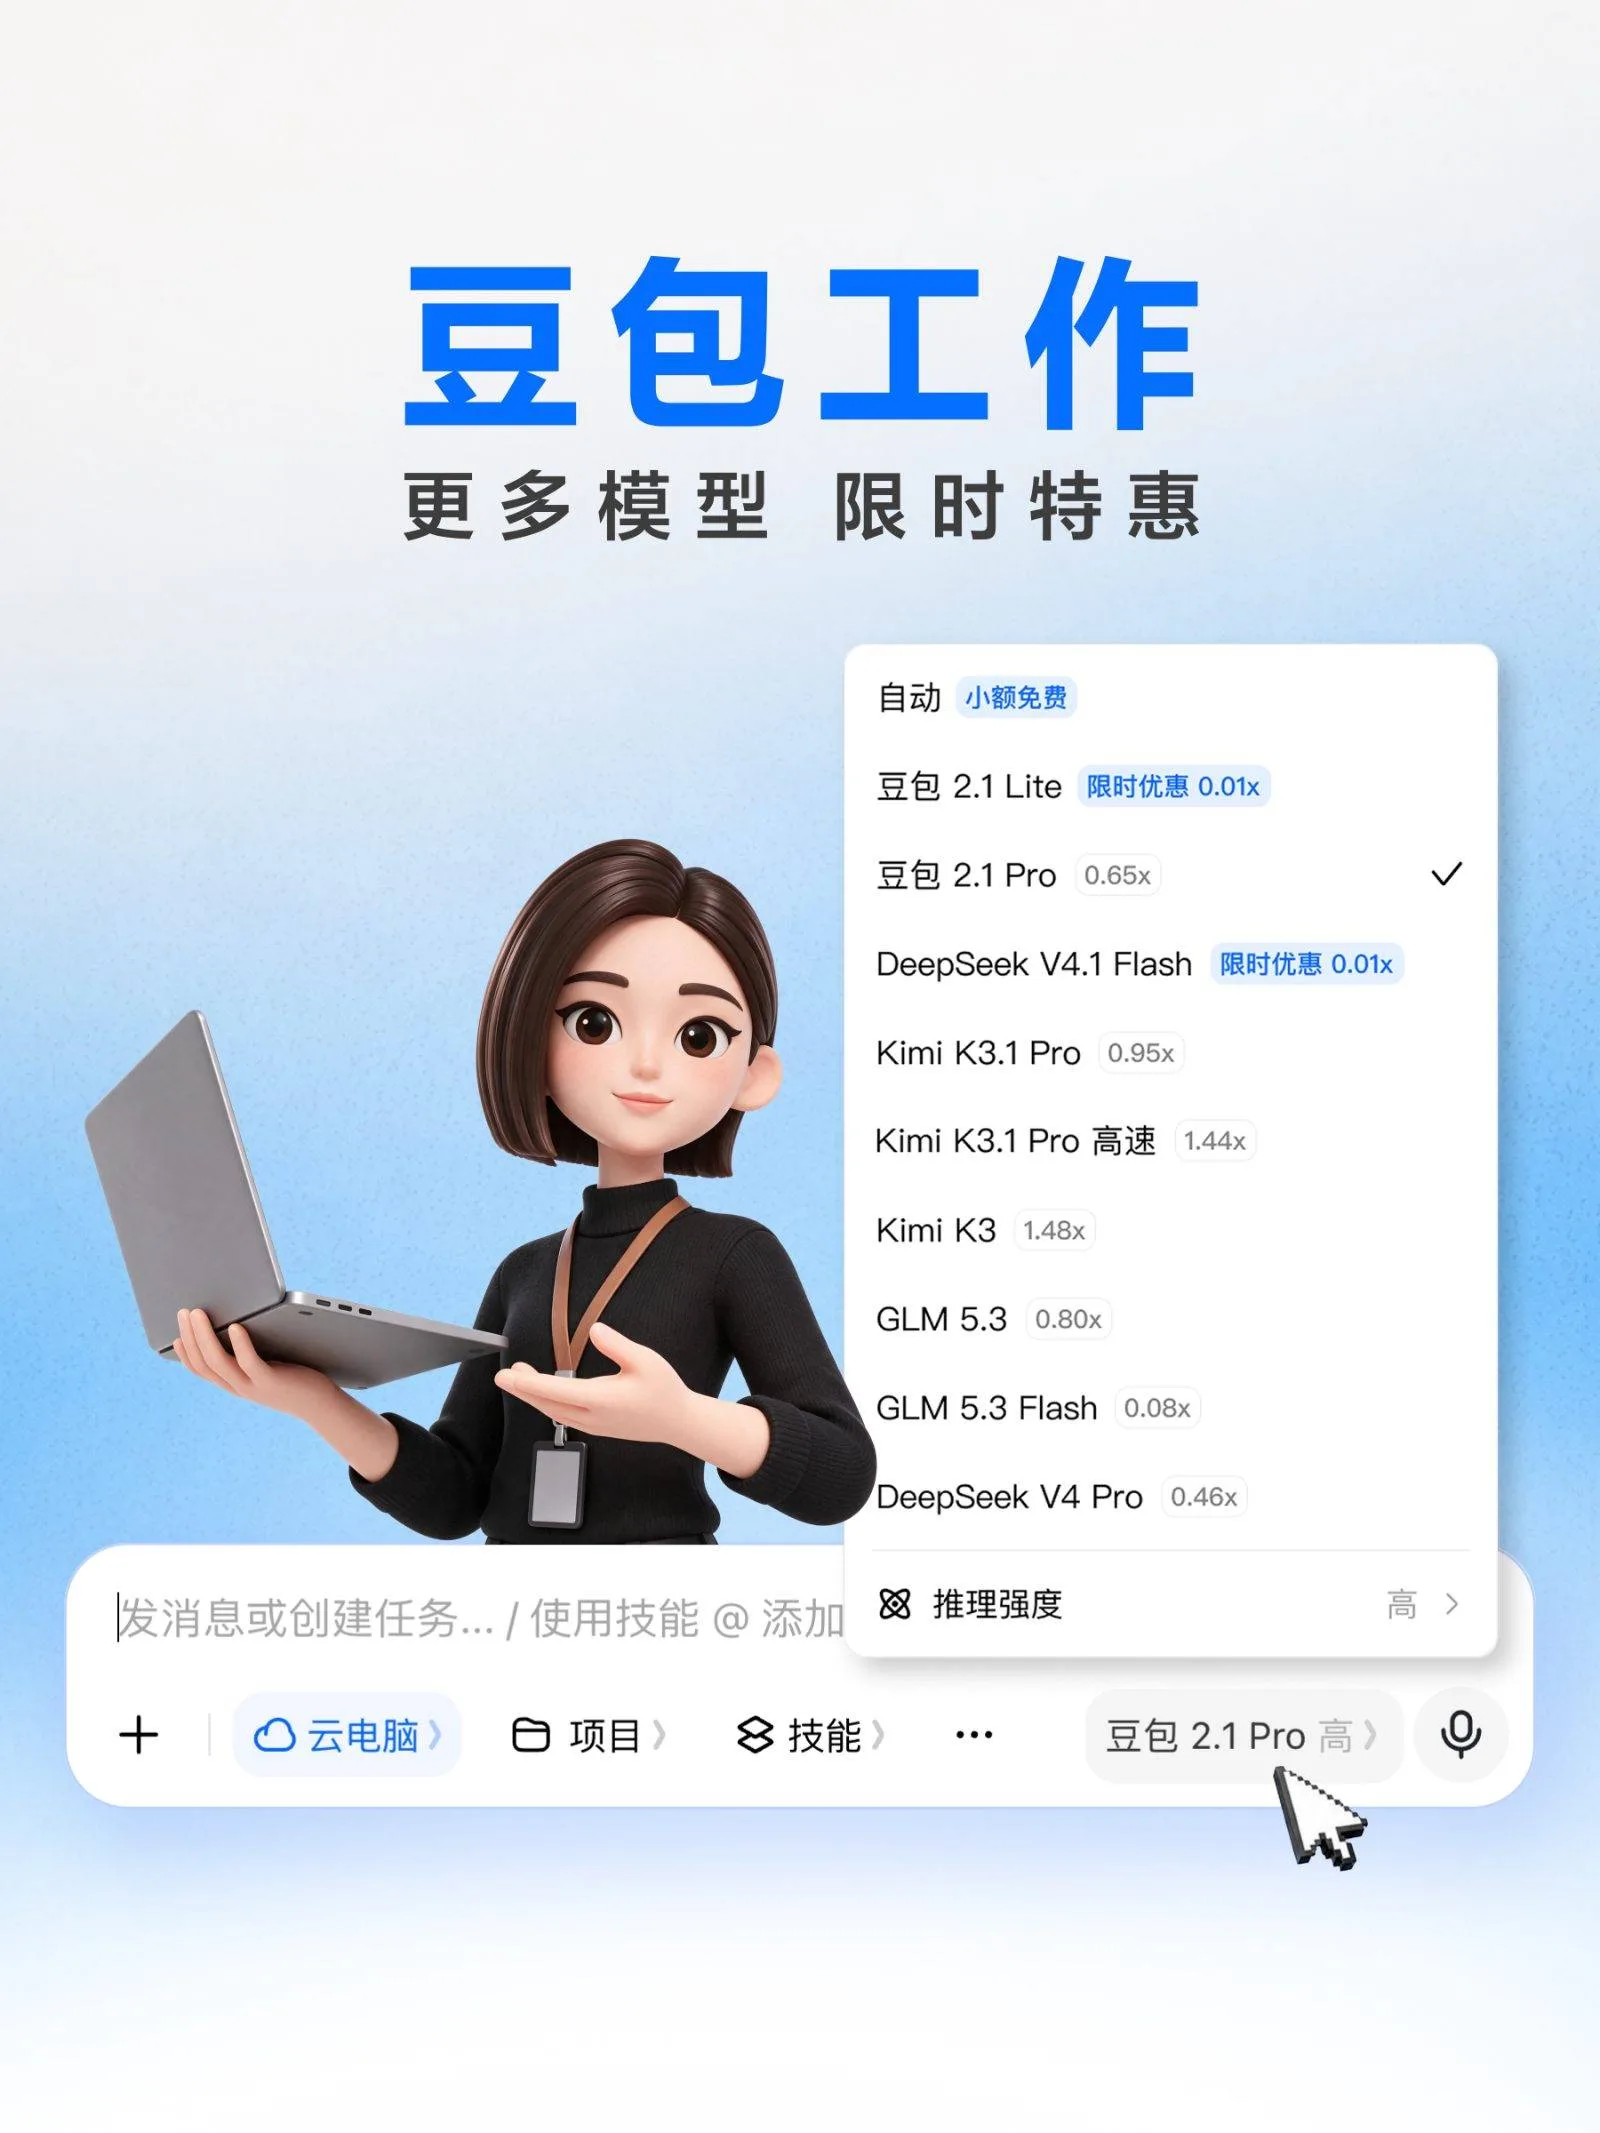
在办公平台上按需切换不同厂商的大模型,正在成为现实。豆包工作宣布,平台新接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并同步推出限时优惠活动。用户可以根据任务需求,自主选择相应模型完成工作。
| 项目 | 说明 |
|---|---|
| 新接入模型 | Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等 |
| 选择方式 | 用户按任务需求在同一平台自主切换 |
| 成本展示 | 模型选择页标注各模型额度消耗倍率 |
| 倍率下调 | 豆包 2.1 Lite、DeepSeek V4.1 Flash |
| 优惠 | 工作日及节假日指定时段额外额度优惠 |
多家模型入驻,同一平台即可切换
继向企业客户开放第三方模型之后,豆包工作进一步扩大了用户的模型选择范围。此次更新后,用户不必在不同工具之间来回切换,就能在同一个工作平台上调用不同厂商提供的 AI 模型。
随着越来越多大模型进入实际办公场景,用户在处理编程、文档写作、数据分析等任务时,对模型能力、响应速度和使用成本的要求各不相同。豆包工作此次更新,正是让模型选择成为办公产品中的一项常规功能。
额度消耗倍率公开,成本一目了然
除了增加模型数量,豆包工作还调整了模型额度消耗的展示方式。平台在模型选择页面进一步标注了各款模型的额度消耗倍率,方便用户直观了解不同模型的使用成本。
按照官方说明,模型的额度消耗倍率越低,通常意味着调用成本越低。用户可以结合任务复杂程度、模型能力及额度消耗情况,选择适合自己的模型。
限时优惠叠加,两款模型下调倍率
在价格方面,豆包工作宣布推出全新的限时优惠计划:用户在工作日及节假日的指定优惠时段内,使用参与活动的模型,可以享受额外的额度消耗优惠。
与此同时,豆包工作已针对豆包 2.1 Lite 和 DeepSeek V4.1 Flash 下调了额度消耗倍率。在处理相同任务时,这两款模型所需消耗的额度将进一步减少,让用户能用现有额度完成更多任务。
平台价值转向”能提供多少选择”
从开放第三方模型,到展示各模型的额度消耗倍率,再到通过限时优惠降低使用成本,豆包工作正试图把模型选择做成办公产品的基础能力。
当越来越多 AI 模型都能在同一款产品中调用时,评价一款办公 AI 产品的标准也在变化:除了单一模型的能力优势,平台能提供多少模型选择、能否让用户以合理成本用上这些能力,将成为影响用户体验的重要因素。
常见问题
豆包工作这次接入了哪些模型? 新增 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型。
用户能自主选模型吗? 可以。用户可根据编程、写作、数据分析等不同任务需求,在同一平台上选择模型。
额度消耗倍率是什么? 平台标注的模型调用成本参考值,倍率越低通常意味着调用成本越低。
哪些模型下调了倍率? 豆包 2.1 Lite 和 DeepSeek V4.1 Flash。
优惠如何使用? 在工作日及节假日的指定优惠时段内,使用参与活动的模型可享额外额度消耗优惠。
信息来源:爱范儿