百度在 2026 年 11 月 5 日正式开源新一代基座模型 文心 5.5 Flash Base(ERNIE 5.5 Flash Base),并向社区开放预训练终点的权重。
模型规格
ERNIE 5.5 Flash Base 是一个稀疏 MoE(混合专家)语言模型,总参数 280B(约 2800 亿),每 token 激活 14B(约 140 亿)。它在 33.5T tokens 上从零完成预训练,最长训练上下文为 128K,微调与推理阶段支持最长 1M tokens 的上下文。
本次开放的权重是预训练终点的 checkpoint,未经中训练与后训练,可作为领域适配、指令微调和强化学习研究的共同起点。
效率优先的架构设计
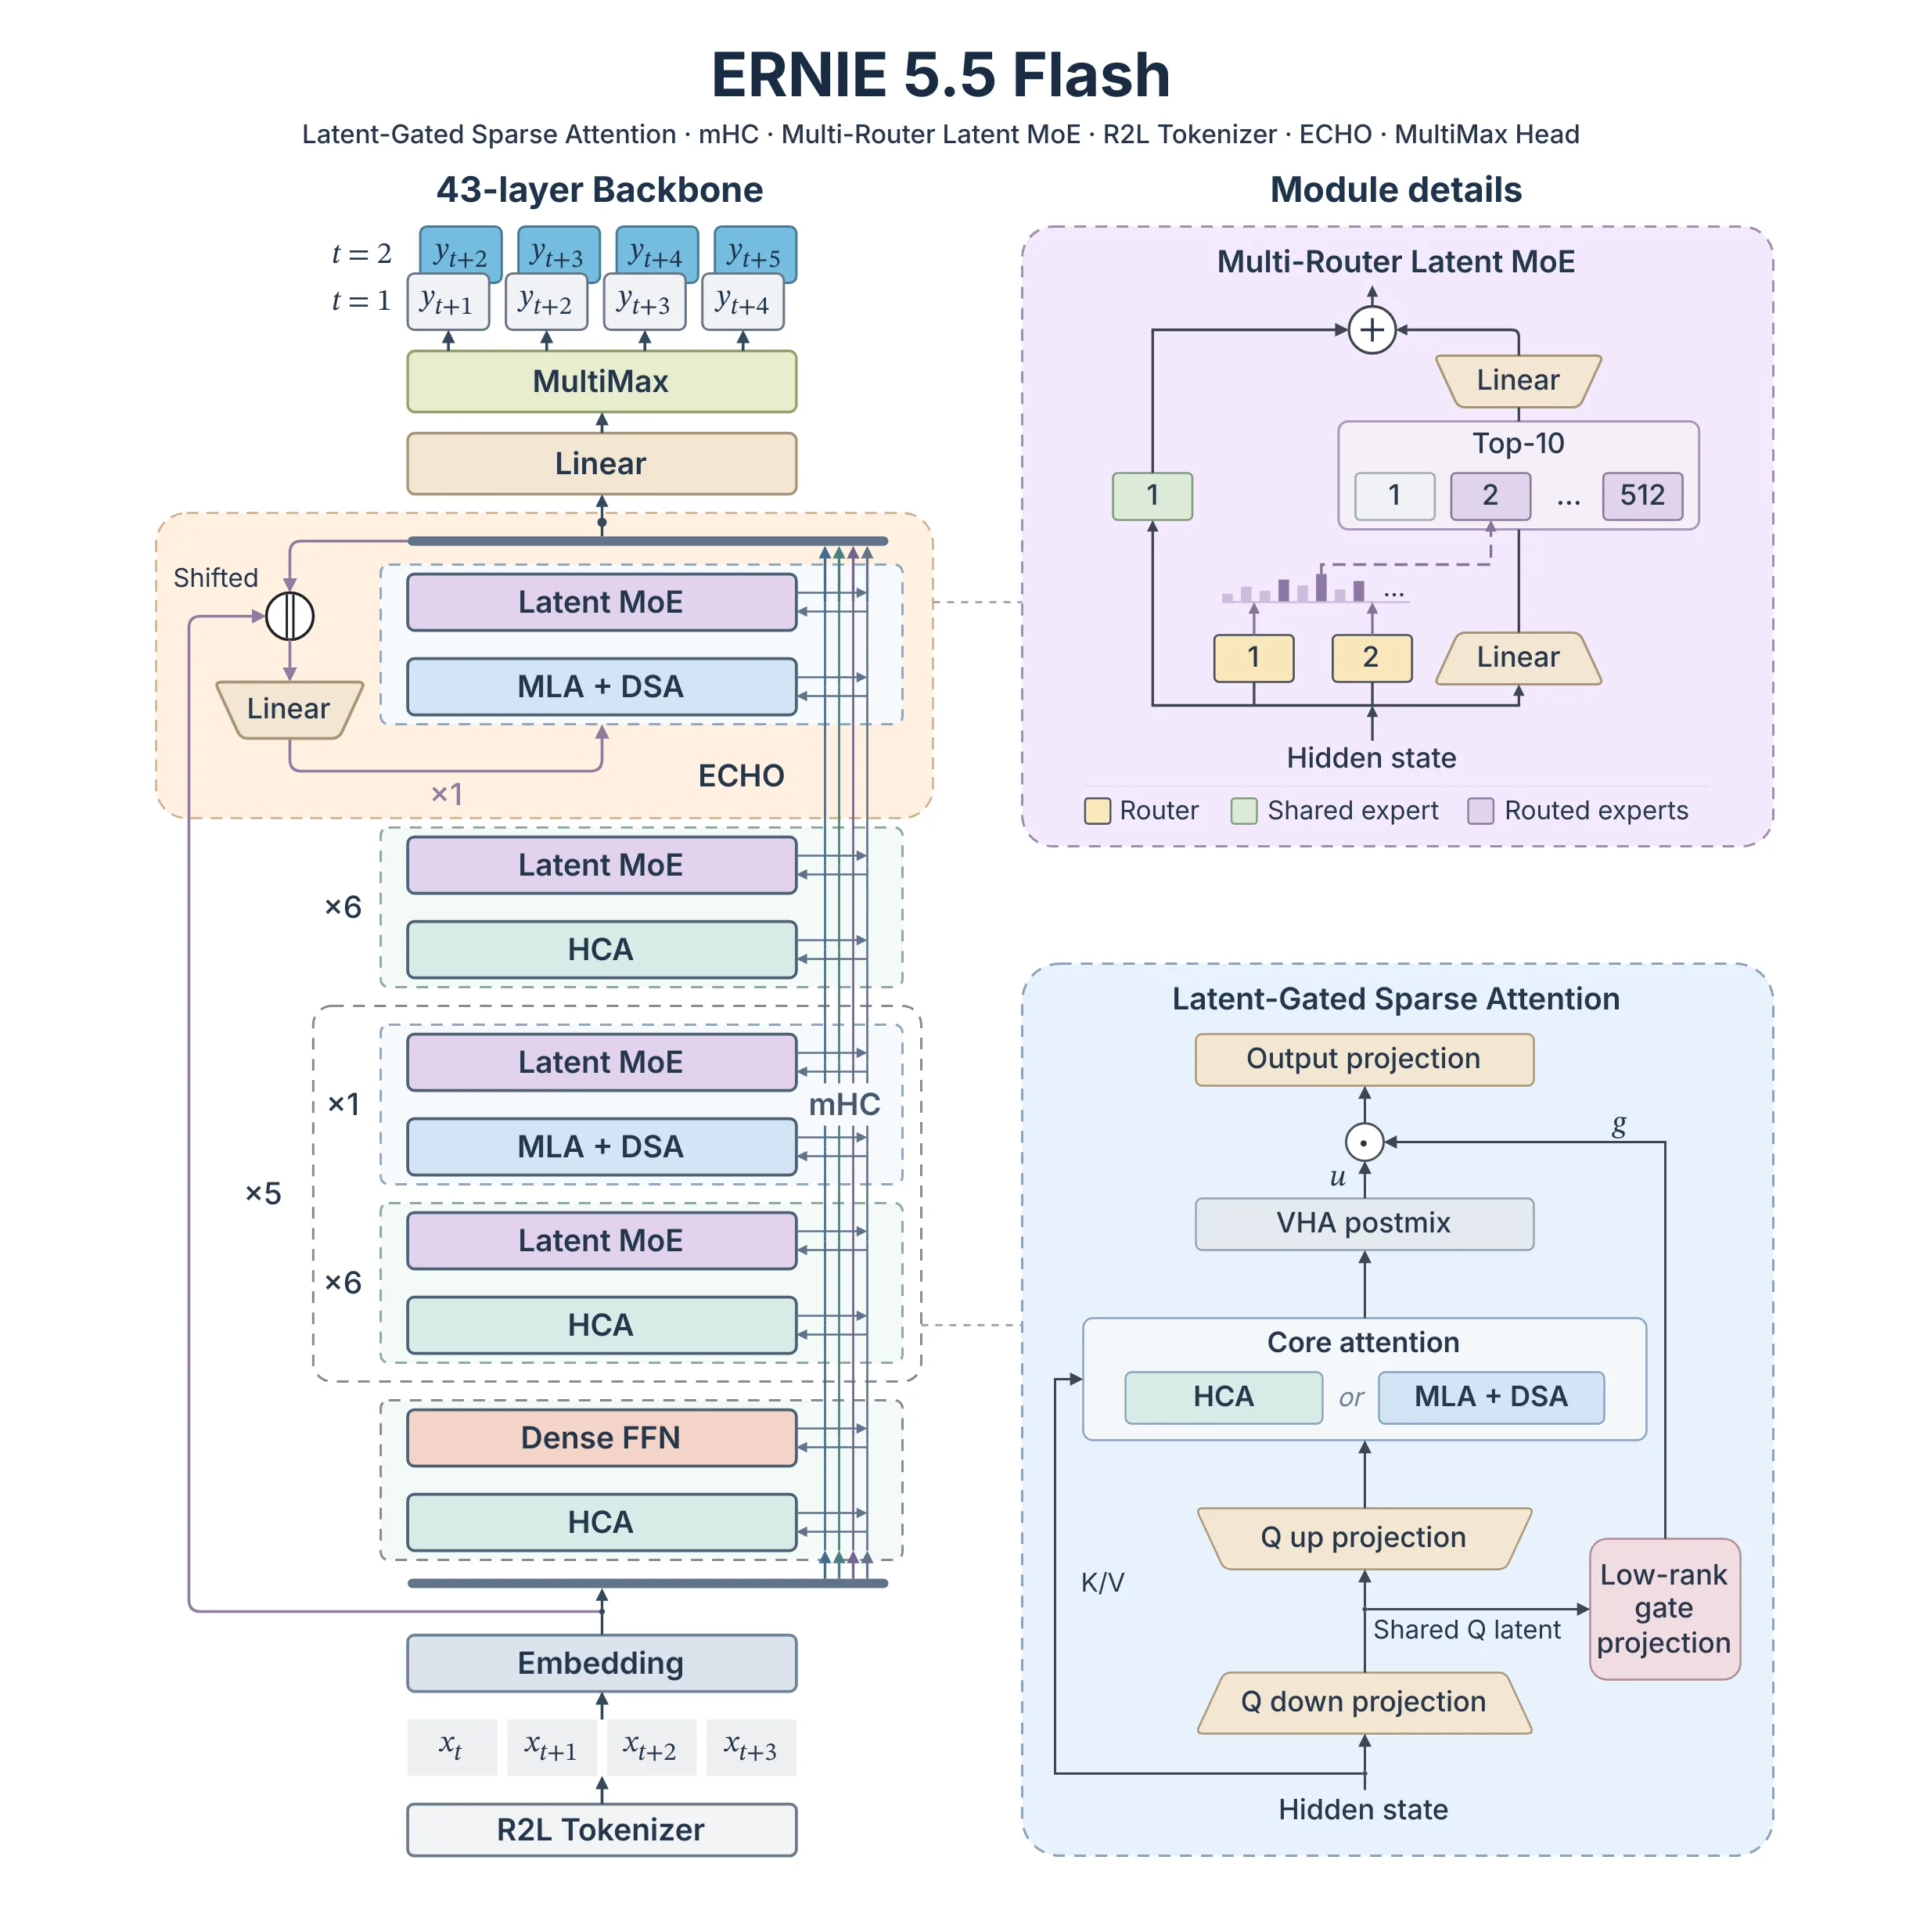
模型围绕”效率”这一主线设计。骨干网络为 43 层 Transformer,隐藏维度 4096,64 个注意力头。其中 37 层采用重度压缩注意力(HCA),每 128 个 token 仅缓存一条;其余 6 层采用多头潜在注意力(MLA)配合稀疏注意力(DSA),保留每个 token。这种混合稀疏注意力在架构层面统筹了模型容量、激活计算与长上下文开销。
专家部分采用 Multi-Router Latent MoE:共 512 个路由专家,每个 token 选择其中 10 个,并额外加 1 个共享专家。此外还引入了 MultiMax 输出头、用主干最后一层取代 MTP 的 ECHO 机制,以及从右到左、三位一组切分数字的 R2L 分词器(词表约 200K)。
评测与获取
百度在 30 项 Benchmark 上评测了该模型,覆盖综合、知识、理科、推理、多语言、代码与长上下文七类能力,并与 DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base 在同框架下对比,各能力维度均表现良好。
模型已在 Hugging Face 上线 FP8(baidu/ERNIE-5.5-Flash-Base)与 BF16 两个版本,许可协议为 ERNIE 5.5 Flash Base Model License Agreement v1.0,并获得了 SGLang、vLLM 与 NVIDIA Megatron-Bridge 的部署支持。经过后训练的 ERNIE 5.5 Flash 将随后推出。
信息来源:百度文心官方技术博客、新华网(2026 年 11 月 5 日)