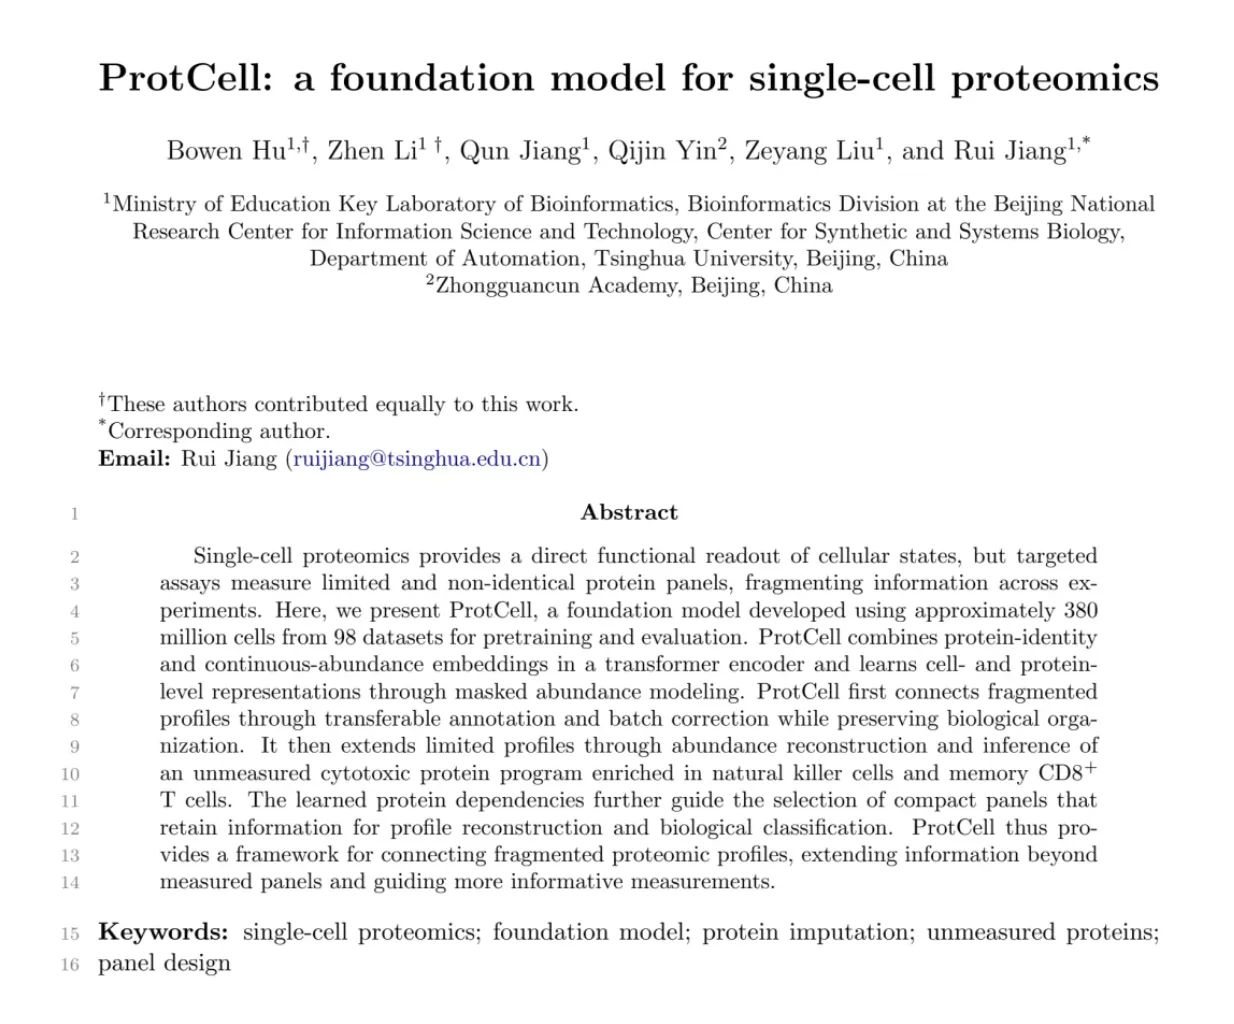
清华大学自动化系江瑞课题组发布了面向单细胞蛋白组的基础模型 ProtCell,并完成了论文《ProtCell: a foundation model for single-cell proteomics》。该模型汇集约 3.8 亿个细胞、98 个公开数据集用于预训练与评估,能够精准映射细胞状态、推断未测蛋白表达,为药物研发与前沿「虚拟细胞」构建提供关键底座支撑。
国产算力复现:关键指标差异仅约 0.2%
论文披露,团队在摩尔线程旗舰级 AI 训推一体智算卡 MTT S5000 上,成功完成了 ProtCell 的全流程预训练复现,主要定量评测指标与国际主流 GPU 平台的差异仅约 0.2%,验证了摩尔线程全功能 GPU(Universal GPU)与 MUSA 全栈软件生态对前沿生命科学基础模型的承载力。
「虚拟细胞」旨在用 AI 在计算机中构建细胞的运行模型,描述细胞当前状态,并精准预测细胞在受到药物、基因编辑等干预后的动态变化,已成为全球 AI4S 竞争的核心战略高地。中国《国务院关于深入实施「人工智能+」行动的意见》将「人工智能+」科学技术列为重点行动首位,而虚拟细胞研发所依赖的基因组、蛋白组等核心数据高度涉及国家生物遗传资源安全,构建自主可控的先进算力基座至关重要。
技术路径:共享词表与掩码丰度建模
ProtCell 以共享词表编码跨实验一致的蛋白身份,结合多层感知机(MLP)编码连续丰度,一并送入 Transformer 编码器以消除技术批次效应;在训练阶段随机遮蔽部分已测蛋白,仅凭同细胞内其余蛋白的测量值推断目标丰度,从而自监督学习细胞内部的蛋白协同网络。
同一模型不仅能完成细胞注释与批次整合,还具备推断面板之外未测蛋白、乃至反哺指导新实验设计的闭环能力。
关键性能数据
| 评测项 | ProtCell | 对比方法 |
|---|---|---|
| 批次内准确率 / macro F1 | 约 0.98 | — |
| 跨批次迁移准确率 | 0.971–0.974 | — |
| 掩码蛋白重建 Pearson | 0.586 | CytoVI 0.484 |
| 79 靶标逐一遮蔽胜出数 | 67 个 | — |
| 未选蛋白重建 Spearman | 0.616–0.630 | — |
| AML 克隆判别中位 AUROC | 0.809 | QR 0.478 / CytoVI 0.475 |
在 Kotliarov2020 数据集上,骨干冻结、仅训练分类头时,批次内准确率与 macro F1 均达约 0.98,跨批次迁移准确率保持在 0.971 到 0.974。掩码蛋白重建中,蛋白级平均 Pearson 相关系数为 0.586,优于对比方法 CytoVI 的 0.484;在全部 79 个靶标逐一遮蔽的测试中,ProtCell 在 67 个靶标上表现显著胜出。
常见问题
问:ProtCell 与传统的单细胞蛋白检测有何不同? 答:传统 CITE-seq、质谱流式等技术依赖预选面板,单次通常仅覆盖数十至数百种蛋白,数据长期碎片化;ProtCell 通过共享词表与掩码建模打通碎片,并能推断面板之外的未测蛋白。
问:论文与代码是否公开? 答:论文预印本于 2026 年 10 月 27 日上线 bioRxiv,代码已在 GitHub 全面开源,官方仓库原生集成了基于 MUSA 软件栈的预训练启动入口。
信息来源
本文基于证券时报、IT之家 2026 年 11 月 14 日报道,以及清华大学江瑞课题组与摩尔线程披露信息整理。