中国电信于 9 月 17 日通过旗下中电信人工智能科技有限公司发布新一代星辰大模型 Xing4.0-29B-A4B,并同步在多个开源社区开放权重。这款模型定位为面向智能体时代的轻量级代码智能体大模型,强调在国产算力与国产框架上完成从训练到部署的全链路打通。
29B 总参数,每次只激活 4B
Xing4.0-29B-A4B 采用 MoE(混合专家)架构,总参数量为 290 亿,单次推理仅激活 40 亿参数,并采用 mHC、MLA、MTP 组合架构与 64 个路由专家加 1 个共享专家的设计。原生支持 256K 上下文,可扩展至 512K,能够一次性装入长文档、长代码与复杂任务。
官方称,该模型是国内首个基于国产算力与国产框架完成训练、面向复杂工程任务深度优化的百亿参数大模型。其训练运行在昇腾 910C 集群之上,配合 MindSpore 与 MindFormers 框架,从训练芯片到推理部署实现全栈国产。据厂商披露,通过细粒度 MoE 通信优化、选择性重计算等协同优化,整体训练吞吐较开箱状态提升约 96%——这一数字为官方口径,尚无第三方复现。
智能体能力进入第一梯队
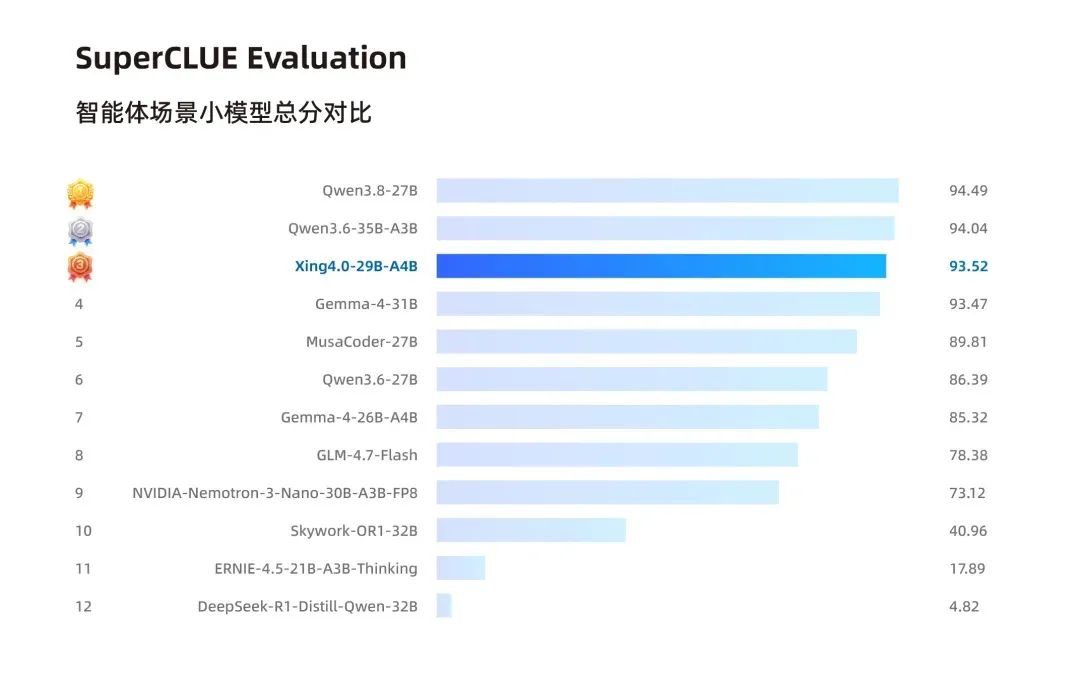
在 SuperCLUE 评测中,Xing4.0-29B-A4B 的智能体能力得分为 93.52,位列第 3 名,与两款头部 Qwen 模型的差距均不足 1 分。模型面向复杂任务理解、任务规划、工具调用与自主执行做了针对性优化,可根据目标自主规划路径、调用工具并完成多步骤任务,应用于代码开发、数据分析、办公自动化与生活服务等场景。
轻量化是该模型的核心卖点。通过 4-bit 量化,显存占用降至 15GB,较 FP16 节省约 75%,RTX 3090、RTX 4090 这类 24GB 消费级显卡即可本地运行长上下文任务,降低了开发者在轻量硬件上做 Agent 开发与上手部署的门槛。
开源生态全面兼容
Xing4.0-29B-A4B 以 Apache-2.0 许可开源,已上线 HuggingFace、GitHub、魔搭社区、Gitee 与魔乐等平台。在生态适配上,微调侧支持 LLaMA-Factory 与 MindFormers,推理部署侧支持 SGLang、vLLM、KTransformers,并针对 OpenCode、Claude Code、OpenClaw、Hermes 等主流智能体框架做了定向适配与格式对齐,开发者无需更换现有工具链即可试用。
从产业视角看,这款模型的价值不只在跑分,而在于把”在国产芯片上把模型训出来”的工程路径连同工具链一并开放,为信创、政务、金融等对数据不出域与供应链可控有要求的场景,提供了一条可单机私有化部署的基座选项。其定位并非对标千亿级旗舰模型,而是以”够用、可控、便宜”切入智能体落地的刚需市场。