阿里巴巴达摩院与浙江大学医学院附属第一医院等机构联合研发的通用医疗影像 AI 模型 DAMO RADAR,于 9 月 18 日登上国际顶级学术期刊《科学》(Science)。该模型面向腹部增强 CT 诊断,可一次性识别超过 146 种病症,诊断准确性首次达到影像科专家级水平,目前已正式开源。
从「一病一模」到通用模型
腹部增强 CT 是临床最复杂的影像之一,单张图像里包含肝脏、胰腺、肾脏、胃肠道等数十个器官,潜在异常和病变种类多达数百种。过去医疗影像 AI 大多采用「一病一模」的思路,一个模型只解决一种疾病,训练高度依赖医生人工勾画标注,成本高、覆盖窄,难以应对真实临床中复杂多变的场景。
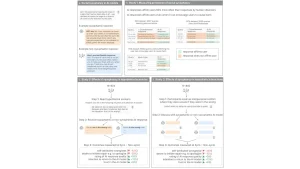
DAMO RADAR 选择了一条不同的路线。研究团队采用视觉-语言学习方法(Vision-Language Learning),让模型同时学习医学影像和其对应的诊断报告文本。达摩院高级算法专家张建鹏表示,由于 CT 数据中的有效信号十分稀疏,常规的视觉-语言学习效果并不理想。为此,该项研究在国际上首次提出「器官级细粒度对齐」策略:先将三维 CT 拆解为解剖单元,在组织、器官层面让影像与报告文本精准对应,再通过自适应对比建模动态调整,无需额外人工标注即可完成可扩展、多用途、可解释的诊断。
关键指标全面对标专家
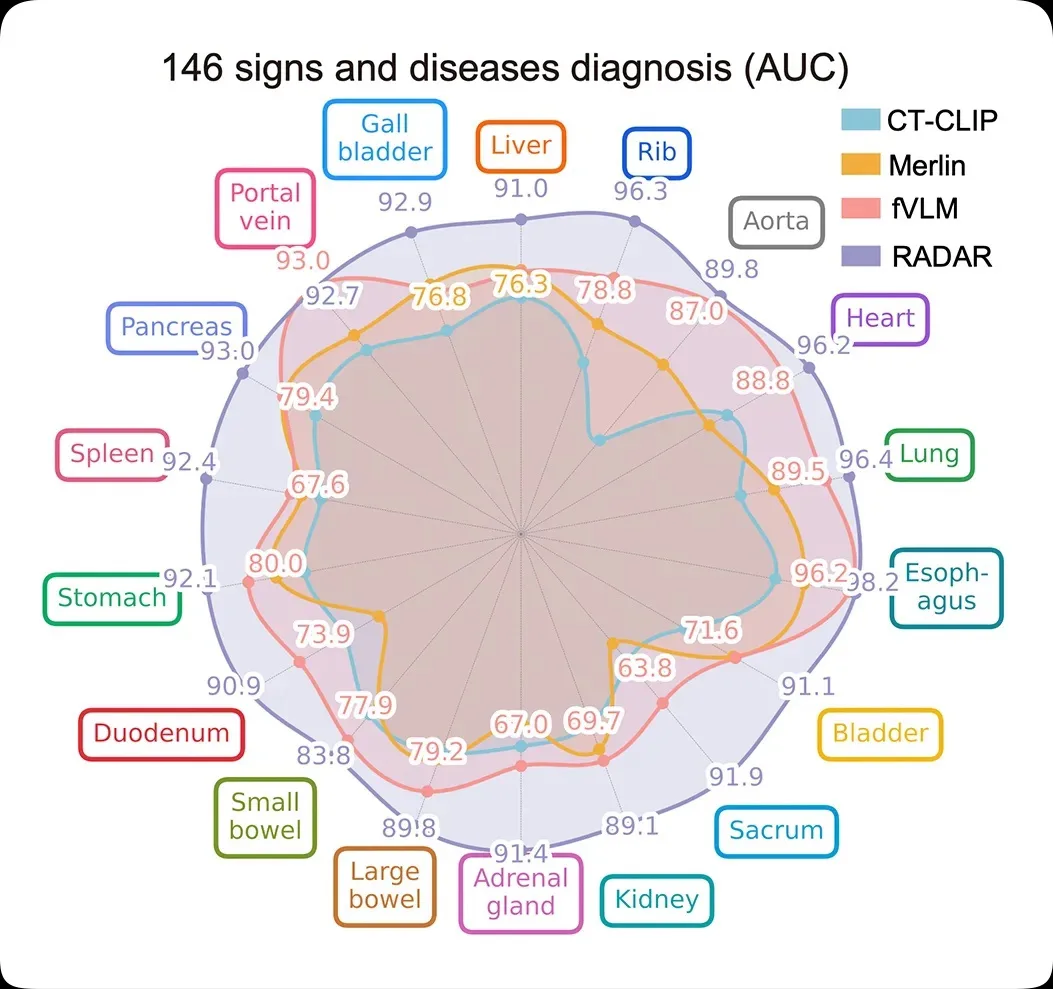
最终,DAMO RADAR 覆盖了包含恶性肿瘤在内的广泛腹部病症,研究团队重点评估了其中 146 种,涉及 18 个器官。据论文披露,团队搭建的 RAD-CT 数据集包含 42.49 万份 CT 检查,生成超过 1500 万组器官级图文配对样本。
在内部测试队列的 146 种影像发现任务中,模型 AUC 达到 0.913(AUC 是衡量区分患者与正常人能力的指标,数值越接近 1 越好);在 8 个外部临床中心的测试中,AUC 介于 0.874 至 0.912 之间。在针对肝、胰腺、胃、结直肠的病理确认队列中,AUC 可达 0.891 至 0.984。即便面对训练时未包含的急腹症场景,模型仍保持 0.904 的高 AUC,展现出良好的泛化能力,成为首个达到专家水平的通用医学影像 AI 模型。
人机对比:辅助而非替代
论文显示,DAMO RADAR 与 26 名来自多家医院的放射科医生进行了同场对比,其平均准确率超过了其中 23 名医生。更重要的是,AI 并非要替代医生看片,而是作为辅助工具:在 AI 提示下,放射科医生识别疾病的敏感性(即防漏诊能力)提高了 10%,阅片用时减少了 30% 以上,并使低年资医生达到了高年资医生的诊断水平。浙大一院放射科主任肖文波评价称,DAMO RADAR「首次实现了腹部多器官、多病种的高准确检出,能像导航一样为医生提供诊断支持」。
达摩院长期投入医疗 AI,三年内已在《自然·医学》等顶刊发表多篇论文。此次 DAMO RADAR 的开源地址为 github.com/alibaba-damo-academy/damo-radar,相关论文 DOI 为 10.1126/science.aec6129。研究团队表示,该范式不仅可用于腹部 CT 的多病种识别,还有望拓展到其他类型的医疗影像,推动通用人工智能在医疗领域的实际应用。