2026 年 9 月 10 日,深度求索(DeepSeek)低调发布 V4.1 Flash 模型。最引人注目的不是参数规模,而是它用一套全新的非对称架构,在性能、费用、速度三项指标上同时超过了自家上一代旗舰 V4 Pro,并将于 9 月 14 日起承接原本发往 V4 Pro 的全部流量。一个体量更小的新模型反超旗舰,在基础模型行业极为罕见。
非对称架构:读和写不再平等
DeepSeek V4.1 Flash 是一个 5520 亿参数的混合专家(MoE)模型,采用全新的因果编码器—解码器(Causal Encoder-Decoder,简称 CED)结构。它的核心思路是:读取输入和生成输出不应该消耗同样的算力。
模型将 40 层 Transformer 拆成两半——前 20 层是因果编码器,后 20 层是解码器。预填充(prefill,即读取输入)阶段只激活 80 亿参数,解码(decode,即生成输出)阶段激活 160 亿参数。知名研究者 Sebastian Raschka 评价,这套改动幅度大到”本该叫 DeepSeek V5″,只涨 0.1 个版本号是低估了它。
这种不对称恰好契合智能体(Agent)的真实工作负载:一个编程智能体可能要读进几万 token 的代码库,最后只产出几行修改;一个研究智能体可能吞下数百万 token 资料,只输出一份摘要。把算力优先分配给”写”而非”读”,单位成本下的有效智能显著提升。
缓存压缩:三年缩小 437 倍
另一项突破是 KV 缓存的极致压缩。V4.1 Flash 每 token 全局 KV 缓存仅需 890 字节,相对初代模型缩小了 437 倍;对高带宽显存(HBM)的需求降至 V4 Flash 的四分之一,对固态存储(SSD)的需求降至八分之一。
在智能体场景中,缓存命中的费用往往占大头,压缩缓存直接压低了长程任务的运行成本。模型还支持 100 万 token 上下文、原生多模态(文本与图像输入),并通过 MIT 协议在 Hugging Face 开放权重。
基准实测:以三分之一参数超越旗舰
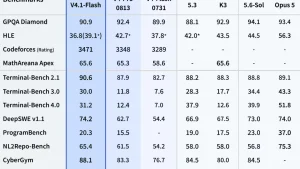
第三方与官方基准显示,V4.1 Flash 在多项智能体任务上超过参数量更大的 V4 Pro:
| 基准测试 | V4.1 Flash | V4-Flash | V4-Pro |
|---|---|---|---|
| — | — | — | — |
| Terminal-Bench 2.1(命令行编程) | 90.6 | 82.7 | 87.9 |
| DeepSWE v1.1(自主修 bug 出 PR) | 74.2 | 54.4 | 62.7 |
| Automation-Bench(跨 SaaS 工作流) | 54.8 | 37.7 | 43.2 |
中文评测方面,V4.1 Flash 在 SuperCLUE 首次进榜即拿到 71.81 分,位列国产第二;第三方机构 Artificial Analysis 的综合智能指数给出 39.5 分,超过自家 V4 Pro 的 36 分。不过 Automation-Bench 仍只有 54.8 分,意味着复杂工作流约一半会失败,生产环境仍需人工把关。
价格与路由:把省下的钱让给用户
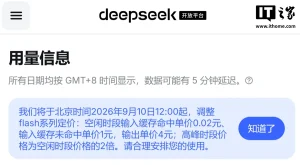
V4.1 Flash 延续 DeepSeek 的峰谷定价,闲时价格为峰时的 50%。以每百万 token 计:缓存输入闲时 0.003 美元、峰时 0.006 美元;未缓存输入闲时 0.15 美元、峰时 0.30 美元;输出闲时 0.60 美元、峰时 1.20 美元。并发上限从 V4 Pro 的 500 提升到 2500。
自 2026 年 9 月 14 日北京时间 12:00 起,至 V4.1 Pro 上线前,访问 deepseek-v4-pro 的请求将全部路由到 V4.1 Flash,并按 Flash 单价计费。旧的 V4 Flash 与 V4-Flash-Vision-Exp 已下线,相关模型名暂时指向新模型以兼容既有调用。WorkBuddy(含 CodeBuddy)、OpenCode 等平台已全面接入 V4.1 Flash。
行业意义:非对称计算成为新前沿
一个低一档的模型在每一项生产指标上超过旗舰并取而代之,验证了深度求索押注的方向——非对称计算,而非单纯堆大对称模型,正在成为基础模型的新前沿。对开发者和企业而言,这意味着在编程、智能体等长程任务上,可以用更低的单价获得更强的有效智能。
本文基于 DeepSeek 官方发布信息、Baseten 技术分析及腾讯云开发者社区资料整理。