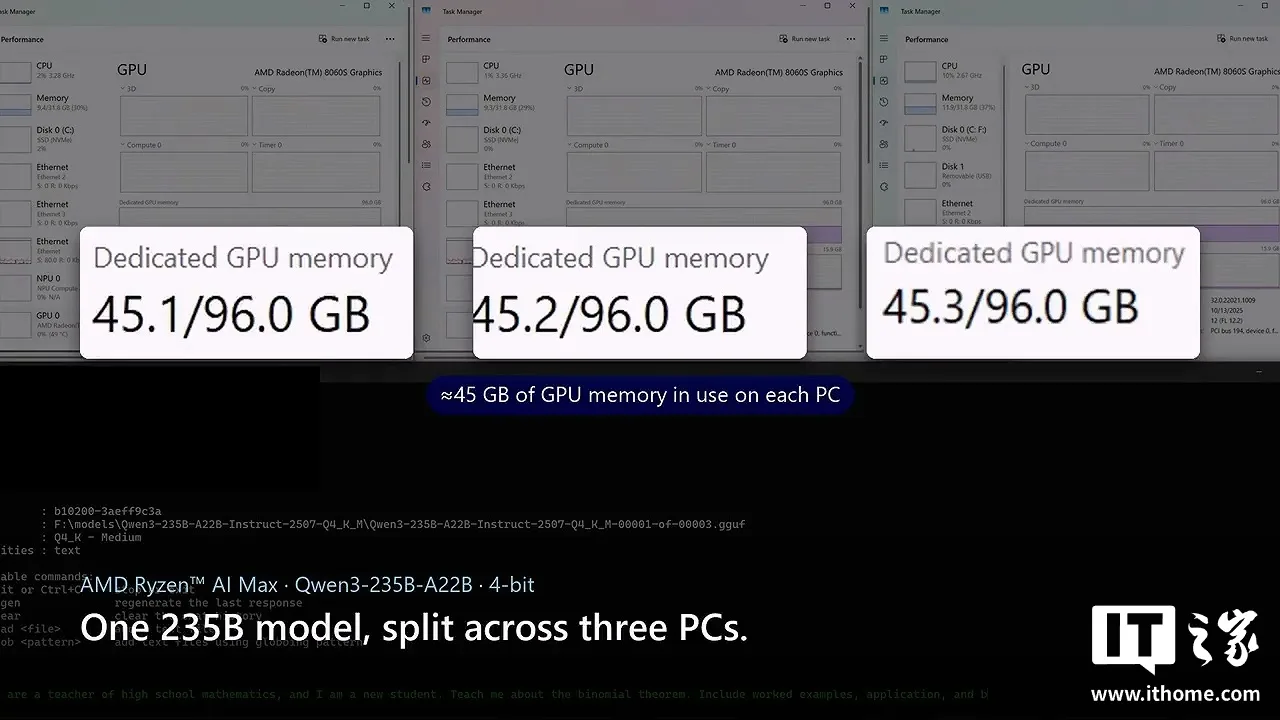
单台电脑内存不够跑大模型怎么办?微软给出的思路是”搭积木”:用一根 USB4 线缆把两台或多台 Windows 11 电脑连起来,让它们调动各自的内存和 GPU 算力,共同运行同一个 AI 模型。2026 年 11 月 19 日,微软以开发者预览的方式推出基于 USB4 的远程直接内存访问(RDMA)体验。初步测试中,三台各配 128GB 统一内存的 AMD 迷你电脑合力跑 2350 亿参数的 Qwen3 模型,生成速度约为每秒 18.5 个词元。
RDMA 是什么,为什么需要它
RDMA(远程直接内存访问)指的是让一台电脑高效地读写另一台电脑中获授权的内存区域,减少操作系统和 CPU 在数据搬运过程中的介入,优势是低延迟、高吞吐和较低的 CPU 占用。
这套机制原本依赖数据中心的专用硬件,要在多台电脑间实现类似协同,通常得另购 RDMA 网卡或配置交换机。微软这次的路径是:符合要求的电脑用 USB4 线缆连接后,无需这些额外硬件,借助兼容的推理框架就能调动各自的内存和 GPU 算力。
意义在于,当推理框架用张量并行把模型分摊到多台机器时,机器间要为每个词元反复交换数据,通信延迟往往比带宽更能决定整体速度。微软把 Windows 已有的 NetworkDirect 接口扩展到 USB4 连接上,并发布了改版 llama.cpp 作演示。
延迟与速度:实测数据怎么说
微软给出的延迟数据是,在单次传输数据量较小的情况下,电脑间通信的往返延迟约为 28 至 50 微秒,仅为同一 USB4 链路上传统以太网 UDP 方式的四分之一。
初步测试分两组。第一组是三台各配 128GB 统一内存的 AMD 迷你电脑,通过 40Gbps USB4 连接,运行 4 位量化的 2350 亿参数 Qwen3 模型,生成速度约为每秒 18.5 个词元;AMD 自己测得约每秒 22 个。在三台搭载 AMD Ryzen AI Max+ 395 处理器的迷你电脑上,具体表现如下:
| 测试方 | 模型与量化方式 | 上下文长度 / 生成词元数 | 解码速度(词元/秒) | 提示词处理速度(词元/秒) |
|---|---|---|---|---|
| AMD | Qwen3-235B-A22B,4 位量化(Q4_K_M) | 1,600 / 2,048 | 21.98 | 117.98 |
第二组来自英特尔,用四台各配 64GB 内存的酷睿 Ultra Series 3 电脑运行 GPT-OSS-120B。微软指出,单台 64GB 内存其实装不下这个模型。在约 1000 词元上下文下,四台机器的生成速度达到每秒 54.2 个词元。增加机器数量带来的提升如下:
| 电脑数量(台) | 上下文长度(词元) | 首个词元生成时间(秒) | 解码速度(词元/秒) |
|---|---|---|---|
| 3 | 1K | 1.1 | 49.4 |
| 4 | 1K | 1.2 | 54.2 |
| 3 | 2K | 2.9 | 49.4 |
| 4 | 2K | 3.2 | 51.7 |
收益有限,且还不是即插即用
从数据看,增加机器数量并非线性提升。以 GPT-OSS-120B 为例,从三台增到四台,1K 上下文下解码速度从每秒 49.4 提至 54.2 个词元,首个词元生成时间反而从 1.1 秒略增至 1.2 秒;2K 上下文下,四台甚至略低于三台。叠加机器能换来加载更大模型的能力,但速度收益要视配置而定。
更重要的是,这还不是开箱即用的功能。开源组件与改装版 llama.cpp 演示已放出,但所需的 Windows Insider 版本构建尚未发布。微软把它定位为面向开发者的起点,而非普通用户可直接升级的桌面功能。其价值在于把门槛从”买专用网卡、配交换机”降低到”插一根 USB4 线”,实际效果仍待后续版本验证。
常见问题
这套方案需要额外买 RDMA 网卡吗?
不需要。符合要求的电脑通过 USB4 线缆连接即可,无需另购专用 RDMA 网卡或配置交换机,但要借助兼容的推理框架。
延迟表现如何?
微软测试显示,小数据量传输时电脑间往返延迟约 28 至 50 微秒,约为同一 USB4 链路上传统以太网 UDP 方式的四分之一。
能跑多大的模型?
测试中三台 128GB 内存的 AMD 迷你电脑跑起了 2350 亿参数的 Qwen3 模型;四台 64GB 内存的英特尔电脑则跑起了单家装不下的 GPT-OSS-120B。
现在普通用户能用吗?
暂时不能。功能以开发者预览形式推出,开源组件已可用,但所需的 Windows Insider 版本和设置说明尚未到位。
信息来源
微软官方博客(2026 年 11 月 19 日);IT之家 2026 年 11 月 20 日报道;凤凰网科技、搜狐、网易科技及 Superpower Daily 同题报道。