结论:OpenAI 于 2026 年 11 月 18 日发布技术报告,其模型让 AMD 旗舰 GPU 的功耗、性能与面积指标最高改善 14%,把约一年的优化压缩到 5 个月内完成。
关键数字:14% 指标改善 / 13% 面积缩减 / 9881 次计分跑测
| 项目 | 数据 | 对比或说明 |
|---|---|---|
| AMD 旗舰 GPU IP 提升 | 最高 14% | 相对已高度优化的基准设计 |
| Jalapeño 向量单元面积 | 减少约 13% | 矩阵单元减少约 10% |
| 研发周期 | 约 1 年压缩至不到 5 个月 | GPT-4o 从 2025 年初参与设计 |
| 评估规模 | 9881 次计分运行 | 单次预算约 11.2 万 Token |
AI 怎么从高度优化的芯片里抠出 14%
OpenAI 从 2025 年初起使用 GPT-4o 协助设计自研推理芯片 Jalapeño。在向量计算单元,模型优化浮点加法器、乘法器、转换函数与归约逻辑;一项乘法器重写让综合后标准单元面积减少约 15%,延迟从两个时钟周期缩短到一个。
矩阵计算单元方面,另一项加法器改版同样减少约 15% 标准单元面积,并保持两周期延迟。整体估算显示,模型方案让向量单元面积缩小约 13%、矩阵单元约 10%,这些改动已在 Jalapeño 流片调试阶段得到验证。
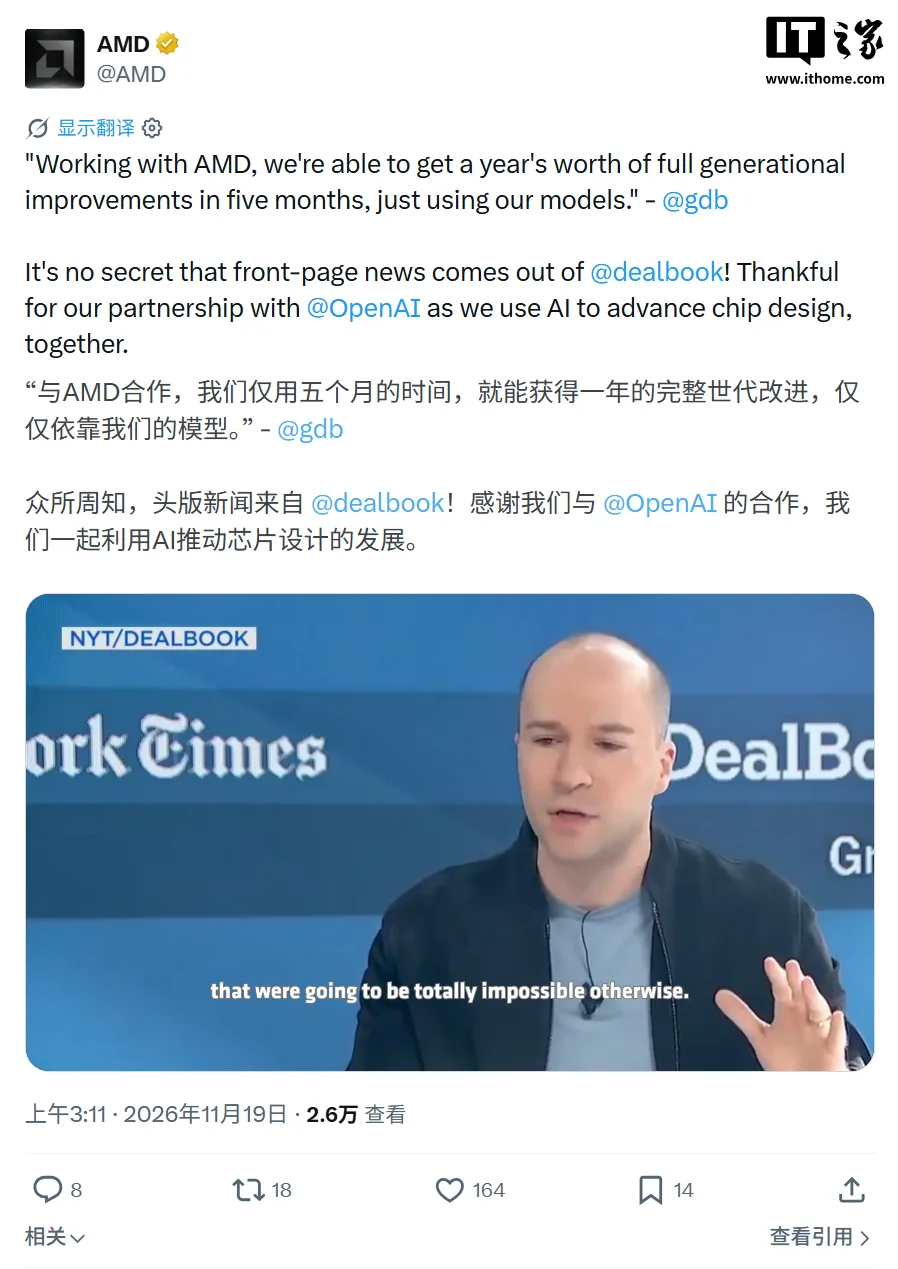
与 AMD 合作时,模型通过重写描述电路的 SystemVerilog 代码挖掘优化空间。在旗舰图形处理器 IP 上,相对深度优化的基准设计最高取得 14% 的功耗性能面积改善,相当于把约一年的进展压缩到 5 个月内。
五款模型同场竞技,GPT-6.2 Astra 领跑
为衡量不同代际模型的芯片设计能力,OpenAI 选用两款开源 32 位精简指令集处理器内核出题:面向可编程逻辑器件的 PicoRV32,以及安全芯片 OpenTitan 采用的 Ibex。
任务要求模型在给定硬件描述代码基础上提升吞吐量,并通过仿真校验正确性。若设计未过校验、或面积超过原设计 16 倍即记零分;通过者按隐藏负载下的每周期指令数与时钟频率折算每秒指令数。
在单次约 11.2 万 Token 的可比预算下,GPT-6.2 Astra 在两款内核上平均分均最高,GPT-6.1 Sol 在两款内核上的得分也都高于 GPT-5.6 Sol。整套评估覆盖两项任务、两款内核及多档 Token 预算,共完成 9881 次计分运行。
从零设计得分更高,但未必等于量产可行
第二项任务不再优化现有内核,而是只给书面规格与代码模板,由模型自行决定数据流转路径和流水线级数。在约 11.2 万 Token 预算下,五款参测模型从零设计的得分都高于优化现有设计。
OpenAI 同时指出局限:从规格重新设计时,模型可能省略性能计数器和扩展指令等对测试负载贡献有限的功能,这在一定程度上解释了得分提升。若强制保留这些功能并加严面积约束、在物理综合后检查时序,结果才会更接近真实量产场景。
对芯片设计团队而言,这项研究的价值在于把模块级优化交给模型完成。这意味着资深微架构师的经验可以更早介入设计收敛,迭代周期从以年计压缩到以月计。值得注意的是,OpenAI 已与新思科技合作训练名为 GPT-Synopsys 的模型,让模型像专业工程师一样使用电子设计自动化工具;但前述局限也提醒业界,测试得分高不等于量产芯片一定占优。
常见问题
这 14% 的提升已经用到量产芯片了吗?
部分已经落地。AMD 把部分优化纳入已送交制造的芯片设计,另一些写入生产设计文件供后续产品使用;Jalapeño 的单元改动已在流片调试中验证。
GPT-6.2 Astra 是唯一表现突出的模型吗?
在约 11.2 万 Token 的同等预算下,它在 PicoRV32 与 Ibex 上的平均分均最高;GPT-6.1 Sol 在两款内核上也都超过了 GPT-5.6 Sol。
AI 现在能独立设计一颗处理器内核吗?
测试中能。五款模型从零设计精简指令集内核的得分都高于优化现有设计,但 OpenAI 指出这类设计可能省掉性能计数器,得分高不代表可直接量产。
信息来源:OpenAI 技术报告《用 OpenAI 模型推进芯片设计》(2026-11-18 发布);IT之家、新浪财经、腾讯新闻 2026-11-19 报道。