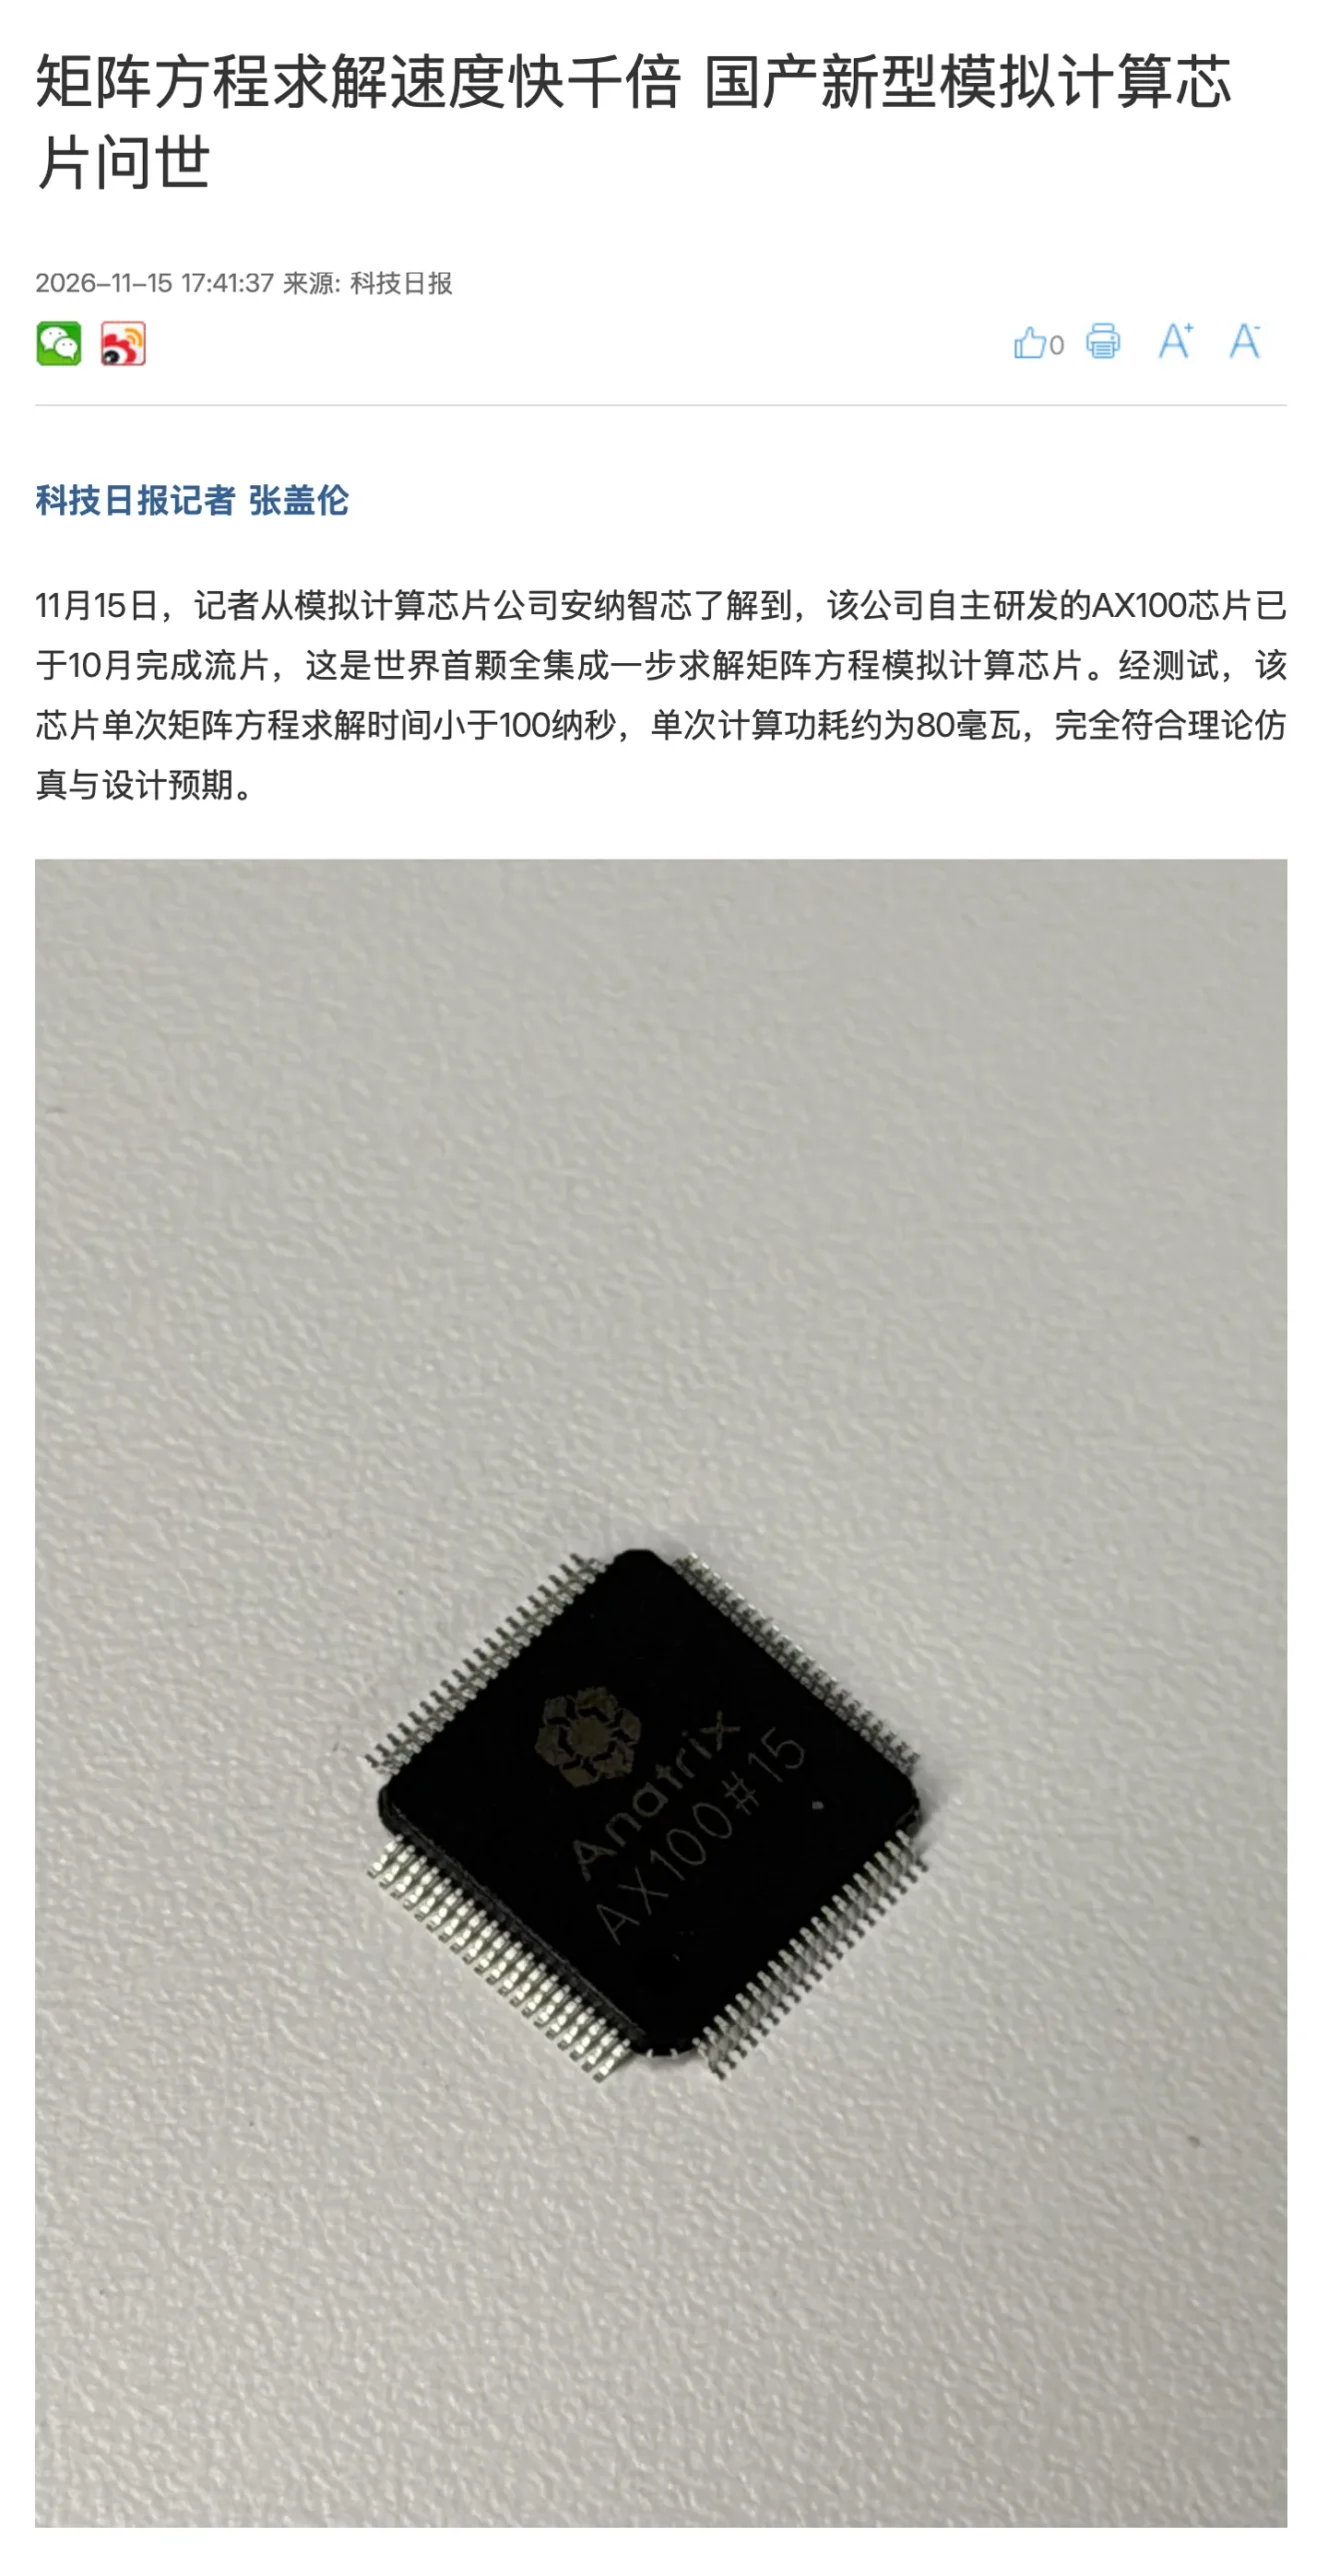
结论:安纳智芯 2026 年 10 月完成 AX100 流片,这是世界首颗全集成一步求解矩阵方程的模拟计算芯片,单次求解时间小于 100 纳秒,单次计算功耗约 80 毫瓦,把原本需要数字芯片反复迭代的运算压缩成一次电路读出。 关键数字:小于 100 纳秒 / 约 80 毫瓦 / 128×128 矩阵吞吐较数字芯片提升 20 至 207 倍。
| 指标 | AX100 表现 | 对照 |
|---|---|---|
| 单次矩阵方程求解时间 | 小于 100 纳秒 | 数字方案数十至上百微秒 |
| 单次计算功耗 | 约 80 毫瓦 | 官方测试数据 |
| 大模型训练更新消耗 | 减少 92% / 56% | Autoencoder / Transformer |
| 机器人运动控制算法 | 提速 150% 至 500% | 端到端算法 |
| 128×128 信道矩阵 | 吞吐提升 20 至 207 倍 | 对比数字 ASIC 与 GPU |
为什么模拟计算能把求解压到 100 纳秒内
AI 大模型训练的参数优化、机器人动作控制与空间规划、通信基站信号处理,本质上都在解复杂的矩阵方程。数字芯片的做法是把求解转化成海量乘加迭代,计算量随矩阵规模呈立方级增长——以 512 阶矩阵方程为例,约需 5 亿次乘加,耗时数十至上百微秒。
模拟计算则直接利用物理定律实现并行运算,延时低、功耗低。安纳智芯 CEO 向锐的表述是:矩阵方程被直接映射为电路,电路自平衡后一次读出结果,无需迭代。这一步到位的机制,是求解时间进入纳秒级的关键。
精度难题是怎样被攻克的
模拟计算长期受制于精度不足,被视为困扰科学界的世纪难题。2025 年 10 月,北京大学人工智能研究院研究员孙仲团队在《自然·电子学》发文,将模拟计算的精度从此前的百分之一量级提升到千万分之一量级,一度被学界评价为”复活”了这一被忽略的领域。
论文正式发表至今仅一年,得益于成熟的芯片制造封装产业链,安纳智芯把孙仲团队的技术从实验室推向产线。这意味着模拟计算第一次在精度上具备了承接真实计算任务的基础。
三类场景的测试表现如何
团队在大模型训练、具身智能、无线通信三类场景对芯片进行了测试。大模型训练面向 293 万参数的 Autoencoder 模型和 272 万参数的 Transformer 模型,二阶优化方案使两类模型的训练更新消耗分别减少 92% 和 56%。
具身智能场景中,运动控制与规划端到端算法提速 150% 到 500%,三维重建与 SLAM 核心环节提速 200% 到 500%。无线通信场景里,对 128×128 规模的信道格拉姆矩阵,等效吞吐较数字 ASIC 与 GPU 提升 20 至 207 倍,等效能效提升 27.6 至 61.3 倍。
这对算力供给意味着什么
AX100 的制造不依赖先进制程,采用当前成熟工艺即可实现全链路自主可控。对需要大规模求解矩阵方程的智算中心、机器人公司和通信设备厂商来说,这条路线提供了一条绕开先进光刻依赖、降低功耗的新路径。
值得注意的是,这只是完成流片并显示实验室测试结果,量产规模、良率与商用交付时间官方均未公布。向锐称这是中国企业第一次有机会参与定义一种重要计算范式,能否兑现仍要看产线表现。
常见问题
AX100 现在已经能量产采购了吗? 官方仅公布芯片于 2026 年 10 月完成流片并给出测试数据,量产时间与采购渠道尚未公布。
它需要使用先进制程工艺吗? 不需要。官方明确该芯片采用当前成熟工艺制造,可实现全链路自主可控。
100 纳秒的求解速度对比数字芯片快多少? 以 512 阶矩阵方程为例,数字方案耗时数十至上百微秒,AX100 单次求解小于 100 纳秒,量级差距明显。
信息来源:科技日报 2026 年 11 月 15 日报道、IT之家同日转述。