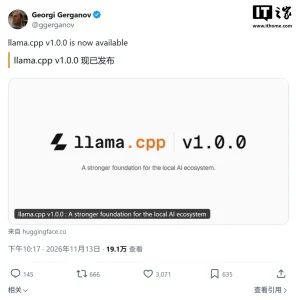
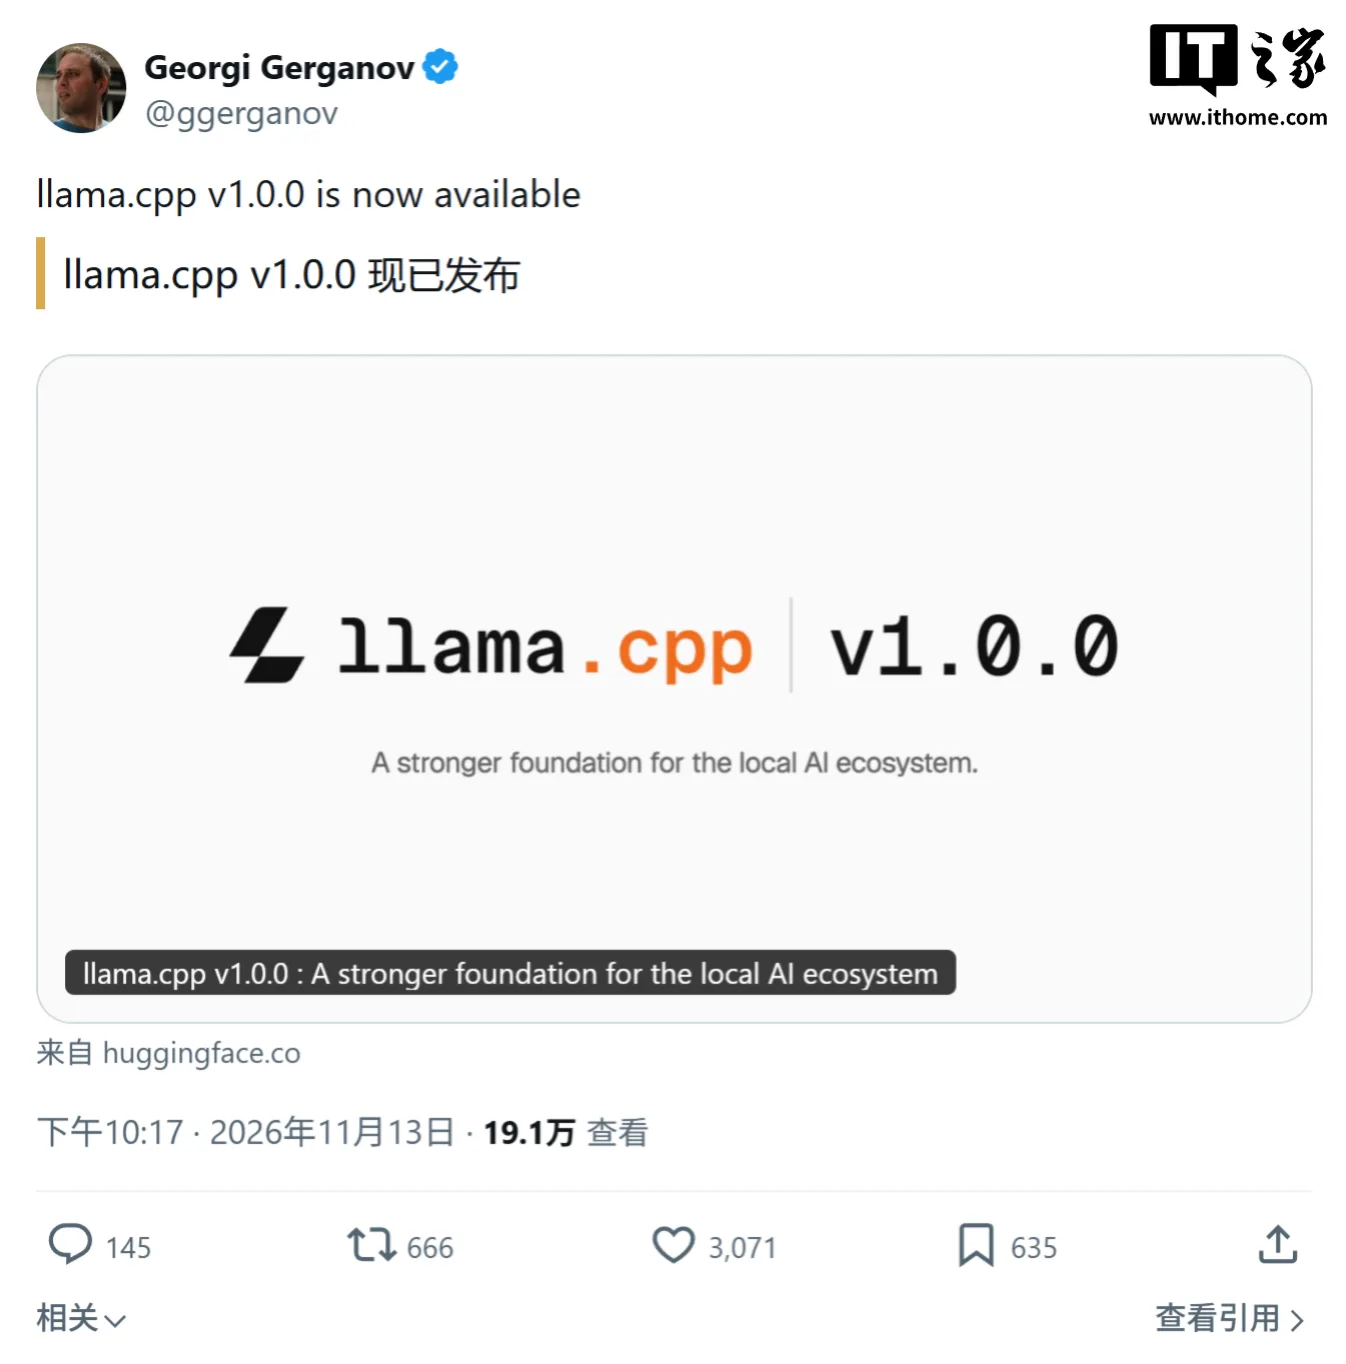
IT之家 11 月 14 日消息,开发者 Georgi Gerganov(X 平台账号 @ggerganov)于 11 月 13 日在 X 平台发布推文,宣布开源 AI 推理项目 llama.cpp 与底层机器学习引擎 ggml 的库版本正式迈入 1.0.0。对于广大在个人电脑和服务器上本地运行大模型的开发者而言,这次更新意味着这套基础软件进入了更清晰的稳定阶段。
谁是 Gerganov
据公开资料,Gerganov 是开源项目 llama.cpp 的创建者,也是 ggml、whisper.cpp 等本地 AI 基础软件的重要开发者。他在个人 X 简介中将自己标注为 Hugging Face 工程师,GitHub 资料所在地为保加利亚索非亚。正是这些项目,让“在本地、断网也能跑大模型”从少数玩家的尝试,变成了普通开发者触手可及的能力。
明确版本兼容规则,是本次最大亮点
本次更新最核心的变化,是明确了一套接口兼容性规则。llama.cpp(C/C++ 编写的大模型推理库)与 ggml(底层机器学习张量库)今后都会通过主版本号升级,来明确标记 API 或 ABI 不兼容的变化,让依赖这些库的上层应用能够识别升级边界。
具体的版本规则为:主版本号(MAJOR,例如从 1.x.x 升级到 2.0.0)在公共 C API 出现破坏性变更时更新;次版本号(MINOR,例如从 1.0.x 升级到 1.1.0)用于向后兼容的功能、后端更新、模型支持或 API 新增;修订号(PATCH,例如从 1.0.0 升级到 1.0.1)则用于不改变 API 的缺陷修复。对开发者来说,今后仅凭版本号就能大致判断某次升级是否要求自己的应用同步修改,升级风险更可控。
支持 150+ 模型架构,跨平台覆盖扩大
在能力与后端方面,llama.cpp 目前已支持超过 150 种模型架构变体,以及主流的推测解码方法。ggml 通过专用后端支持不同硬件,每个后端都可以编译为动态库,并在运行时按需加载,从而把同一套推理能力适配到多种芯片平台。
工程质量层面,团队强调了三项投入:一是借助 Hugging Face 的 HF Buckets 与 HF Jobs 扩展持续集成基础设施;二是在英伟达、AMD、高通、Arm、IBM、英特尔的硬件支持下,持续增加覆盖主要硬件平台的自托管测试运行器;三是在开发流程中审慎使用大语言模型,同时始终把代码质量、架构控制与对实现细节的理解放在首位。团队还表示将继续加强自动化测试基础设施,并借力上述芯片厂商的硬件资源,扩大跨平台测试覆盖。
llama.cpp 主要用 C/C++ 编写,核心作用是让大语言模型能够在个人电脑、服务器等不同硬件上运行,既可用于本地部署,也可用于云端服务,目标是降低部署复杂度并充分利用设备自身的算力。换句话说,它让“断网环境下也能满血跑大模型”成为现实,这也是它在开发者群体中长盛不衰的根本原因。