11月4日,小鹏集团联合北京大学、香港大学等高校研究团队发布具身感知基座模型GroundingPI。该模型以约40亿参数规模,在34项公开感知基准的综合评测中位列第一,综合得分73.68,超过OpenAI前沿模型GPT-6 Astra的71.54分。这一结果让「感知优先」的具身智能路线受到关注。
物理AI与具身智能被视为人工智能产业的重要方向。现有通用大模型多面向办公、对话、编程等数字场景设计,直接用于自动驾驶与机器人等物理场景时存在适配差距。行业主要有两条路线:一是对通用大模型做微调改造后用于具身训练,二是训练原生具身模型,从一开始就以具身任务为目标、只输入机器人相关数据。GroundingPI选择了第三条路径——「感知优先」。
GroundingPI与GPT-6 Astra对比
| 模型 | 参数量 | 34项感知基准综合得分 |
|---|---|---|
| GroundingPI | 约40亿 | 73.68 |
| GPT-6 Astra | 未披露 | 71.54 |
感知优先:先搞懂「物体在哪里」
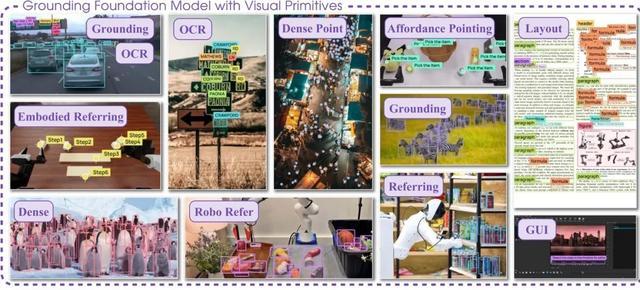
研究团队认为,具身智能的首要前提是精准感知自身与周边物体的空间位置,感知表征对物理AI至关重要。如果模型无法准确定位目标在画面中的位置,学再多动作知识也难以落地。基于这一判断,GroundingPI在训练阶段不使用带关节动作标签的机器人数据,而是全部采用无动作标签的纯感知数据,覆盖通用检测、密集小目标、指代定位、文字识别、文档版面、界面元素、机器人空间定位等11类感知能力,目标是让模型先理解「物体是什么、在画面的哪个位置」。
举例来说,当被要求找到「右边那个杯子的把手」时,模型需要用点或边界框标出杯子和把手的具体位置——仅仅回答「图里有杯子」还不够,语言里的目标必须对应到画面中的具体区域。项目名称也源于此:Grounding对应视觉定位这一核心感知能力,PI为Physical Intelligence(物理智能)的缩写。
落地价值:降本与泛化
官方表示,该研究目前处于科研原型阶段,但实验设计已指向具身领域的落地方向,并直面量化部署的两个核心问题。第一,显著降低示教成本:机器人完成一个新任务通常需人工采集千百条示教数据,以GroundingPI为视觉底座的系统仅用50%示教数据,成功率即超过对比模型使用75%数据的表现。第二,带来更强的场景泛化性:面对材质、物体品类、容器、背景等现场变量变化时,系统能保持更强的稳定性,缓解「换一个空间就不会做」的痛点。在仿真环境的散料分拣、料箱清点等高密度场景中,系统能够分类抓取同类工件,为「一套权重跨工位复用」提供实验支撑。
常见问题
GroundingPI是什么
它是小鹏集团联合北大、港大等团队发布的具身感知基座模型,采用「感知优先」路线,专注让机器人在物理场景中精准理解物体的类别与空间位置。
它的评测成绩如何
在34项公开感知基准的综合评测中,GroundingPI得分73.68,位列第一,高于GPT-6 Astra的71.54分。
相关代码和模型是否开源
是的。官方已公开网站、论文、代码与模型权重,欢迎业界共同验证。
信息来源
本文事实与数据综合自IT之家、凤凰网科技、新浪财经2026年11月4日报道,以及项目公开页面(groundingpi.github.io、arXiv论文、GitHub与Hugging Face仓库)。