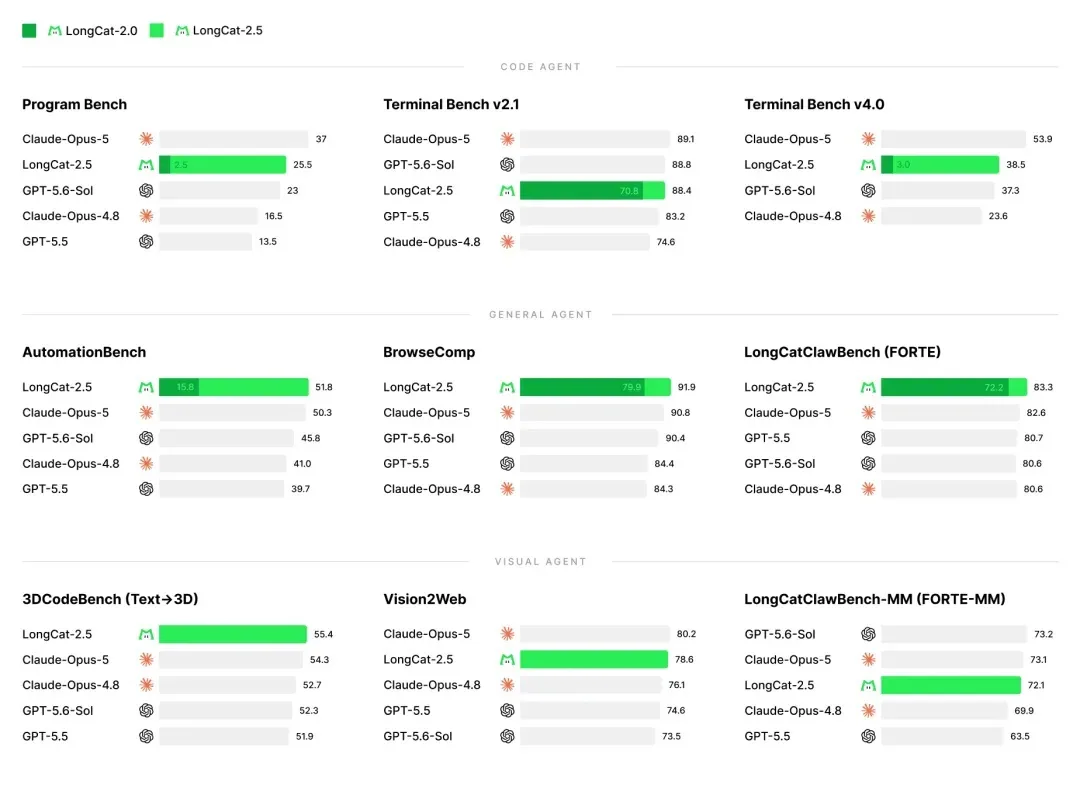
美团龙猫于 11 月 2 日正式发布 LongCat-2.5,这是一款面向长程智能体任务的原生多模态大模型。该模型总参数量达到 1.6 万亿,每个 token 激活约 480 亿参数,在 LongCat-2.0 的基础上进一步强化原生视觉理解与智能体编程能力,瞄准复杂代码库开发、完整项目构建等端到端工程场景。
参数规模与模型定位
LongCat-2.5 采用混合专家(MoE)架构路线,总参数量为 1.6 万亿,每个 token 激活约 480 亿参数。官方明确表示,该版本在 LongCat-2.0 的基础上强化了两项核心能力:原生视觉理解,以及智能体编程(Agentic Coding)。在此之前,LongCat 系列已经开放过 2.5-Preview 版本,原生支持 100 万 token 的上下文窗口,适合处理超长文档、代码库、日志与多轮复杂任务,本次正式版延续了这一定位并做了能力升级。
长程智能体能力强化
在长序列训练中,龙猫团队加入了更多长程轨迹数据,并通过大规模长程强化学习,提升模型在复杂代码库开发、完整项目构建等任务中的端到端工程能力。围绕数据合成、环境构建与跨 Harness 混合训练,官方持续扩展这条训练链路。
值得关注的是,龙猫将真实 Agent 的失败轨迹转化为可复现、可验证的训练任务,针对模型能力短板持续补充训练数据。这一做法旨在让模型在真实工程中少走弯路,提升一次成功率。
原生多模态与视觉编程
LongCat-2.5 将视觉信号表示为多层级离散 token,使主干模型以统一的 token 形式处理视觉与文本输入。原生视觉理解与智能体编程能力的结合,使模型在 Visual Coding(可视化编程)上表现出色,并支持创意设计和 3D 等任务。这意味着模型可以同时”看懂”图像与代码,在涉及界面、设计稿、截图的工作流中具备更直接的操作能力。
基础设施与国产算力
官方表示,这些升级由持续演进的基础设施支撑:一方面优化国产算力上的长上下文训练与 4 位权重、4 位激活(W4A4)量化推理;另一方面通过训推数值一致性和长上下文 rollout 优化,支撑大规模长程强化学习的高效运行。这显示出国产大模型在训练与推理效率上的持续投入。
体验与开放方式
根据官方信息,用户可以通过 longcat.chat 进行在线体验,开发者可通过 longcat.chat/platform/product 接入 API。GitHub 与 HuggingFace 的模型权重则”即将上线”。随着原生多模态与长程智能体能力的补齐,LongCat-2.5 试图在 Agent 时代为企业级自动化编程与多模态任务提供更完整的底座。