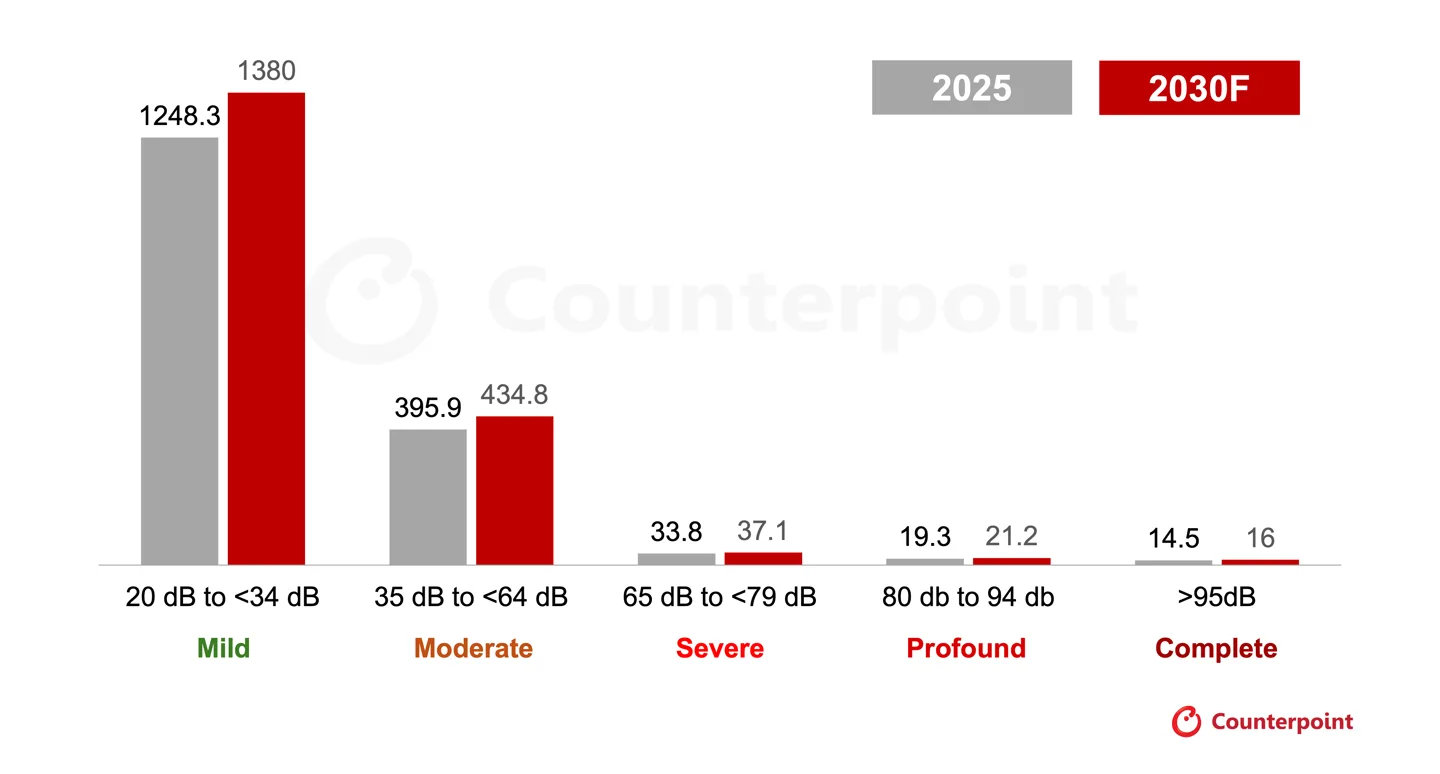
市场研究机构 Counterpoint 在最新发布的《全球端侧 AI 可穿戴设备预测》中指出,到 2030 年,全球处方助听器销量预计将突破 3100 万台,2025 至 2030 年期间的年复合增长率约为 4%。更值得关注的是,随着人工智能在助听设备中的加速渗透,到 2030 年预计将有近 50% 的助听器产品搭载端侧 AI 能力。
传统方案的瓶颈
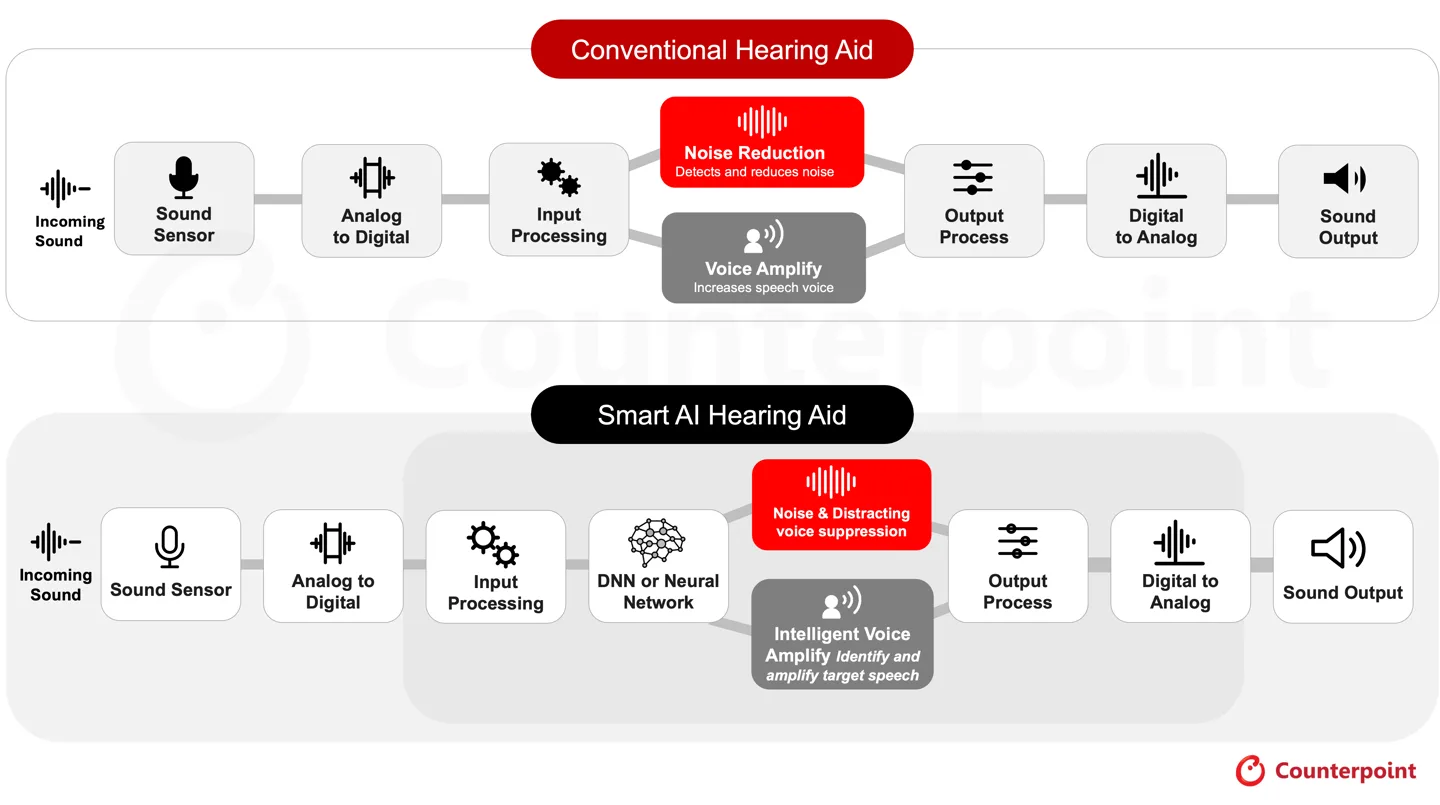
助听器在小型化、连接性与续航等方面已演进多年,但核心难题始终没有彻底解决:用户在嘈杂环境中往往难以听清对话。传统助听器主要依赖数字信号处理(DSP)技术,由麦克风采集环境声音,处理器分析频率、音量等特征,再通过预设算法决定放大或压低哪些声音。这种方式对空调、发动机等稳定噪声颇为有效,但真实场景要复杂得多——拥挤餐厅里可能同时夹杂乱的对话、音乐与餐具碰撞声,基于规则的系统很难判断用户真正想听的是谁。
AI 如何改变听觉体验
人工智能给出了另一条路径。与依赖预设规则不同,AI 模型通过学习即可区分人声与其他声音的模式。经过数百万组人声与背景噪声样本训练的深度神经网络,能够实时识别说话者声音并抑制无关噪声。它不仅能分离人声与噪声、突出目标说话者、增强空间感知,还能持续适应环境变化。
在细微语音的辨别上,AI 尤其擅长处理「s」「f」「t」「sh」「th」这类容易混淆的发音,也能帮助用户区分读音相近的数字。通过在本地保留这些精细的语音特征,AI 不只是在放大音量,更切实提升了餐厅、会议、街道等场景下的语音理解能力。
临床「噪声中语音识别」测试显示,听力正常的听者通常需要约 2 分贝的信噪比才能正确识别一半关键词;而对轻中度感音神经性听力损失者,这一门槛上升到约 8 分贝。AI 恰好能在信噪比上带来可量化的改善。以峰力(Phonak)的测试为例:固定指向麦克风搭配传统设置,相比全向麦克风可将信噪比提升 6.4 分贝;加入 AI 降噪后,默认设置下提升达到 9 分贝,最大设置下可达 10.2 分贝,足以支撑用户在餐厅中顺畅交流。
端侧运行的硬约束
AI 还让助听器朝着更自动化、更个性化的方向发展。机器学习可根据用户偏好与聆听场景自适应调整声音处理,减少手动调节,降低跟随对话所需的认知负荷,从而缓解聆听疲劳、减少重复询问。
但这类体验对延迟极为敏感。从麦克风采集声音,到处理完成再传回耳朵,整个链路必须控制在 10 毫秒以内,否则用户会出现视听不同步,或觉得自己的声音不自然。这与智能手机截然不同——手机可以把数据传上云端、等 AI 返回结果再处理,而助听器无法承受这样的往返延迟。实时语音处理必须发生在设备本地,这正是端侧 AI 的价值所在:声音在贴近麦克风与受话器的本地完成分析。
续航与体积的现实代价
把 AI 塞进助听器并不容易。这类设备电池容量极小、算力有限、体积约束严苛,要对模型与处理器做高度优化,才能在实现降噪的同时把功耗压到最低。持续运行神经网络会带来显著的续航折损:峰力 2025 款 Audéo Infinio Ultra Sphere 常规使用续航约 56 小时,一旦持续开启 AI 功能,续航会骤降到 10 小时,直观体现出本地运行 AI 的代价。
端侧 AI 让助听器变得「智能」,但真正的研发难点在于高效集成:每一点清晰度的提升,都要以续航与空间为代价。下一代助听器的核心竞争力,就在于让 AI 在后台静默运行,在提供更清晰人声、更低聆听负荷、更个性化体验的同时,不过度耗电、不增大体积。一场围绕端侧 AI 的技术竞赛,已经在行业内展开。