太平洋时间 10 月 7 日上午 10 点(北京时间 10 月 8 日凌晨 1 点),微软在旧金山举办的发布会上宣布,GitHub Copilot 将在本月底前支持本地 AI 模型推理,开发者可在云端模型与设备端模型之间自动或手动切换。
云端与本地双轨切换
GitHub Copilot 是微软推出的 AI 编程助手,可集成于 Visual Studio Code、命令行工具(CLI)等环境,根据代码上下文生成补全、解释或重构建议。长期以来它依赖云端托管模型,由协调器根据性能、成本与准确性来路由请求。本月底扩展后,Copilot 将能自动选择云端模型与本地 AI 模型,在后台协调推理任务。
微软为开发者提供两种模式:自动编排,或强制使用设备端模型。偏好可在 GitHub Copilot CLI、Copilot 应用与 VS Code 中设置。在本地模型的选择上,开发者可以指定提供程序、模型或端点,通过 Windows ML 选用 MAI Code 1.1 Flash,或连接 OpenAI 兼容的本地端点。
1370 亿参数模型塞进笔记本
支撑本地推理的是微软新推出的 MAI Code 1.1 Flash”混合专家”(MoE)模型。它总参数达到 1370 亿,但每次仅激活 68 亿参数,并采用量化与推测解码技术来优化响应速度与内存占用。
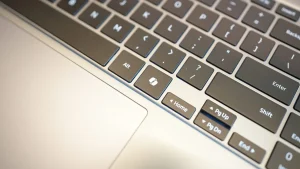
该模型面向搭载英伟达 RTX Spark 超级芯片的设备,例如 Surface Laptop Ultra——其最高提供 128GB 统一内存与 1 PFLOP(FP4)的 AI 算力。设备端量化版本模型体积约 53GB,较云侧 Bfloat16 版本减重约 80%(平均约 3.3 bits/weight)。
实测性能与基准
微软公布的实测数据显示:在 Surface Laptop Ultra 上,64k 上下文的提示处理吞吐达到每秒 923.5 个词元,128k 上下文为每秒 769.8 个词元;解码吞吐在提示长度从 2K 到 256K 词元时,介于每秒 40 至 63 个词元之间,256k 上下文下的峰值内存占用为 75.5GB。
基准测试方面,MAI Code 1.1 Flash 在 SWE-Bench Verified 上取得 70.8% 的成绩(云侧版本为 72.6%,作为对比的 GPT-OSS-120B 为 32%);在 Terminal-Bench 2.1 上,设备端量化版本达到 66.29%(云侧版本为 62.9%)。
微软将这一能力视为 HydraFusion 愿景的延伸——推理编排不再局限于多模型,而是扩展到包含边缘侧在内的多计算环境。配合 Microsoft Execution Containers(MXC)对智能体编码会话的安全隔离,本地执行的代码不再产生云端 token 费用,开发者得以按场景自主选择用云还是用本地。